Engenharia de fiabilidade
Quando as novas tentativas se tornam a interrupção
Uma pequena lentidão pode se tornar uma falha em todo o sistema quando cada camada tenta se recuperar sozinha. Siga a corrente – e os limites que podem detê-la.
Siga a cadeia de falhas
- 1. Um pequeno atraso ganha uma segunda vida
- 2. A multiplicação acontece entre equipes
- 3. As salas de espera não criam capacidade
- 4. Construa um limite que a sobrecarga não possa ultrapassar
- 5. A retirada altera o tempo; jitter muda de empresa
- 6. O tráfego de recuperação precisa de uma rota para casa
- 7. Procure o trabalho que está sendo feito
- 8. O sistema que pode parar de tentar
Uma intenção, vinte e sete tentativas possíveis
Abrir visual em tamanho real ↗Explicação e suposições
Pior caso de ramificação ilustrativa: três camadas, cada uma permitindo três tentativas no total, incluindo o original. Nenhum sucesso antecipado ou cancelamento; o tráfego real depende da implementação. As áreas do anel não são uma medida de carga de trabalho.
A primeira solicitação com falha costuma ser a parte menos interessante de uma interrupção. Uma dependência demora mais que o esperado, um chamador desiste de esperar e o aplicativo tenta novamente. Parece uma ação de recuperação sensata. A dificuldade aparece quando milhares de outros chamadores chegam à mesma conclusão, várias camadas fazem suas próprias tentativas e o trabalho original ainda está em execução. O sistema está agora a gastar uma parte crescente da sua capacidade na recuperação da carga criada pelos seus mecanismos de recuperação. Nada em um loop de repetição individual precisa parecer obviamente irracional para que o comportamento combinado se torne destrutivo.
Considere um serviço de status de pedido explicitamente hipotético. Normalmente tem capacidade suficiente para o trabalho recebido, mas uma dependência downstream fica lenta por dois minutos. As solicitações permanecem em andamento por mais tempo, o tempo limite do chamador começa a expirar e uma biblioteca cliente inicia outra tentativa. Um serviço externo também possui uma política de novas tentativas. Uma interface de usuário oferece um botão de nova tentativa porque seu próprio prazo expirou. A procura empresarial quase não mudou, mas a dependência vê mais tentativas de trabalho precisamente quando consegue concluir menos. Este artigo segue essa cadeia e depois examina os locais onde um design pode interrompê-la. O cenário e cada exemplo numérico são ilustrativos, não um relato de um incidente de cliente MGCA ou um benchmark medido.
Uma nova tentativa é uma nova solicitação de recursos, mesmo quando representa uma intenção antiga. Essa distinção é o ponto de partida para a compreensão do fracasso. A empresa ainda pode querer uma atualização de status, uma inscrição enviada ou um relatório preenchido. A infraestrutura pode estar processando diversas tentativas de produzi-lo. Se os painéis contarem as solicitações sem conectá-las à operação subjacente, a atividade extra poderá parecer um aumento na demanda do cliente. Se o sucesso for medido por tentativa e não por resultado útil, o serviço também pode parecer mais saudável do que a experiência da pessoa que o espera.
1. Um pequeno atraso ganha uma segunda vida
Um tempo limite responde a uma questão local: quanto tempo esse chamador irá esperar? Ele não responde, por si só, se a operação remota foi interrompida, falhou antes da execução ou foi concluída sem entregar o seu reconhecimento. Esses são resultados diferentes. Para uma leitura, repetir a solicitação pode consumir principalmente recursos. Para uma gravação, um resultado incerto também pode criar um problema de correção. O sistema receptor pode já ter confirmado a alteração. O desejo do chamador de receber uma resposta definitiva não torna outra execução segura. A proteção da capacidade e a correção dos negócios precisam, portanto, ser consideradas em conjunto, em vez de atribuir novas tentativas a uma camada de transporte e assumir que o restante da aplicação não será afetado.
A primeira resposta a uma desaceleração geralmente é aumentar o tempo limite. Isso pode reduzir falsas falhas onde a variação normal foi confundida com uma interrupção. Também pode manter mais solicitações ocupando recursos por mais tempo. A redução do tempo limite cria a compensação oposta: os chamadores liberam o estado de espera mais cedo, mas podem iniciar tentativas de substituição enquanto o trabalho anterior permanece ativo. Nenhuma das direções é inerentemente correta. A questão útil é quais recursos permanecem ocupados, quais trabalhos realmente param e como o prazo escolhido se relaciona com o valor da conclusão da tarefa. Alterar um número sem responder a essas perguntas pode diminuir a pressão, em vez de removê-la.
Também há mais de um relógio. Estabelecer uma conexão, resolver um nome, obter um token de identidade, aguardar uma conexão em pool e receber a resposta pode consumir parte do tempo disponível do chamador. Um tempo limite de solicitação que exclui uma espera anterior pode dar uma impressão enganosa da operação total. Por outro lado, subsídios generosos de forma independente em todas as fases podem produzir um atraso global muito além da promessa feita ao utilizador. Um projeto precisa de um relato coerente do tempo decorrido, incluindo o tempo gasto antes do início da chamada remota e entre as tentativas. O limite importante é a tarefa inteira, e não o temporizador mais fácil de configurar.
No serviço hipotético, imagine que a página visível pare de esperar após cinco segundos, enquanto um cliente interno pode continuar por vinte. Esses valores não são configurações recomendadas. Eles expõem um problema de propriedade. Durante parte desse período o serviço poderá estar trabalhando em uma solicitação cujo leitor original já tenha saído. Se a página enviar uma nova operação, o trabalho antigo e o novo competirão. Se o cancelamento for propagado, o componente receptor ainda precisa definir o que pode cancelar com segurança. Interromper uma espera de rede e desfazer uma transação confirmada não são a mesma capacidade. Um prazo pode acabar com a utilidade de um resultado sem reverter os seus efeitos.
O primeiro ponto de interrupção é consequentemente um prazo que tem dono. Um componente deve saber quanto do tempo restante da operação pode ser gasto, se outra tentativa pode terminar dentro dela e o que acontece quando esse tempo se esgota. A resposta pode ser uma falha evidente, uma operação assíncrona retida com uma referência de status ou um resultado marcado como incompleto. Não deve ser uma transferência invisível do mesmo trabalho para outro loop de novas tentativas ilimitado. Uma política de recuperação é útil quando aumenta a probabilidade de um resultado válido dentro das restrições reais da tarefa.
As orientações de engenharia da Amazon discutem tempos limite, espera, instabilidade e o risco de que uma chamada expirada já tenha produzido efeitos colaterais. A Microsoft descreve o antipadrão de tempestade de novas tentativas relacionado: tentativas frequentes podem impedir a recuperação de um serviço com dificuldades. Estas fontes apoiam o mecanismo amplo, em vez de validar os números específicos deste artigo. O raciocínio de design que se segue aplica esse mecanismo a um serviço deliberadamente simplificado, para que as consequências permaneçam inspecionáveis. [1] [2]
2. A multiplicação acontece entre equipes
Três tentativas parecem modestas. Três camadas, cada uma permitindo três tentativas no total, podem ser bem diferentes. Sob a suposição específica do pior caso, de que cada tentativa externa causa todas as tentativas internas, e nenhuma é bem-sucedida antecipadamente, a dependência mais profunda pode receber vinte e sete tentativas para uma operação original. Isso é uma multiplicação na hierarquia de chamadas, e não uma afirmação de que toda falha produz automaticamente essa contagem. Cancelamento, prazos, sucesso antecipado, estado do circuito e a propriedade real da nova tentativa podem reduzi-lo. O objetivo do cálculo é expor uma interação que é fácil de perder quando cada componente é revisado de forma independente.
A terminologia é importante aqui. Uma configuração descrita como três tentativas pode significar uma tentativa original e mais três, enquanto três tentativas incluem o original. Confundir essas definições altera o cálculo antes que qualquer detalhe de implementação entre nele. Uma discussão sobre arquitetura deve anotar o total de tentativas permitidas em cada fronteira e identificar qual componente as inicia. Deve também incluir o comportamento fornecido pelas bibliotecas clientes, gateways e infraestrutura. Um diagrama que mostra apenas o código do aplicativo pode omitir o mecanismo de nova tentativa que domina o tráfego. O componente que oculta uma falha do seu chamador ainda contribui para a carga de trabalho do sistema.
A causa organizacional é compreensível. Cada equipe deseja que seu próprio serviço tolere uma breve interrupção. Uma biblioteca compartilhada adota uma política padrão. Um gateway adiciona outra camada de proteção. Um trabalhador trata uma exceção como um motivo para abandonar e receber a mensagem novamente. Nenhuma dessas escolhas precisa ser descuidada. O fracasso surge porque as políticas partilham uma dependência sem partilharem um orçamento. A resiliência local tornou-se otimismo coletivo: cada participante assume que outra tentativa é viável, enquanto nenhum participante é responsável pelo número total de tentativas que a operação comercial pode gerar.
O diagrama radial na abertura torna isso visível. Seus anéis representam uma operação original, depois três, nove e vinte e sete possíveis tentativas posteriores em um modelo deliberadamente restrito. Os anéis não são medições de tráfego e suas áreas não são estimativas de desempenho. Eles são uma forma de inspecionar a suposição de ramificação sem desenhar outro cenário retangular de aplicação. Siga uma única intenção externa e pergunte onde o novo trabalho é criado. Se várias camadas puderem expandi-la de forma independente, revisar apenas as tentativas máximas do cliente final não estabelecerá a carga máxima que toda a rota pode impor.
Uma resposta prática é tornar explícita a propriedade da nova tentativa no limite onde a aplicação tem contexto suficiente para julgar a operação. Isso não significa que todo sistema deva centralizar toda a lógica de resiliência em um só lugar. Um transporte pode recuperar razoavelmente uma conexão interrompida enquanto um aplicativo gerencia uma tarefa mais longa. O requisito é que seu comportamento combinado seja compreendido e limitado. Uma camada inferior não deve reiniciar silenciosamente uma ação comercial completa depois que a camada superior acreditar que esgotou o limite da tarefa. A fronteira entre reconectar, reenviar e reexecutar precisa ser visível tanto no projeto quanto na observação.
Um orçamento de repetição adiciona um segundo limite além do máximo por solicitação. O aplicativo pode restringir a quantidade agregada de trabalho extra que introduz durante a falha. A unidade contábil deve ser escolhida deliberadamente: solicitações, tentativas simultâneas, tempo decorrido, custo ponderado ou uma combinação. Uma leitura barata em cache e um relatório caro não são necessariamente tokens intercambiáveis. O mecanismo também deverá definir o que acontece quando o orçamento fica vazio. Simplesmente mover as tentativas rejeitadas para uma fila privada preserva a pressão enquanto a oculta do limitador original. Um orçamento útil altera o comportamento que atinge o recurso limitado.
Não existe uma percentagem universal que torne tal orçamento correto. A capacidade de recuperação disponível, o contrato de dependência, o valor da tarefa e o comportamento de falha são diferentes. Um serviço pode reservar uma margem limitada para erros transitórios curtos, ao mesmo tempo que se recusa a multiplicar trabalhos dispendiosos durante falhas persistentes. Outro pode adiar tarefas elegíveis para um processo em segundo plano controlado separadamente. O que importa é que a política permaneça significativa quando o sistema está sob pressão, quando os sucessos são escassos e quando vários interlocutores falham em conjunto. Um orçamento cuja reposição depende do sucesso necessita de uma interpretação explícita desse período de baixo sucesso, em vez de um bloqueio acidental ou uma anulação de emergência ilimitada.
Uma tentativa fracassada não é uma nova instrução de negócios
Para um serviço com capacidade de gravação, a identidade da operação precisa sobreviver à tentativa. Se um cliente gerar um novo identificador comercial cada vez que reenviar a mesma intenção, um destinatário poderá razoavelmente tratar as solicitações como operações diferentes. Se reutilizar um identificador sem verificar o conteúdo associado, a mesma chave poderá ser anexada a alterações materialmente diferentes. Um projeto de idempotência, portanto, precisa de mais do que um campo denominado ID de solicitação. Precisa de um escopo, uma relação com a ação pretendida, um período de retenção e uma resposta definida quando um identificador repetido chega com conteúdo incompatível.
O registro do resultado é igualmente importante. Se o receptor puder identificar uma operação concluída, mas não puder recuperar seu resultado, o chamador poderá permanecer incerto, mesmo que a execução duplicada seja evitada. O serviço deve decidir se pode devolver o resultado anterior, fornecer uma referência de estado ou exigir investigação. O arranjo correto depende da operação e de seus requisitos de tratamento de informações. A distinção geral é estável: reconhecer uma instrução antiga, prevenir outro efeito e explicar o efeito existente são capacidades relacionadas, mas não são entregues automaticamente pelo mesmo mecanismo.
3. As salas de espera não criam capacidade
Uma fila pode facilitar o controle de uma carga de trabalho. Separa a aceitação da execução e dá aos consumidores a oportunidade de processar o trabalho a um ritmo sustentável. Também pode ocultar uma promessa crescente que o serviço não consegue cumprir. A profundidade da fila, portanto, não é uma métrica de sucesso nem uma explicação por si só. Uma fila contendo dez relatórios lentos pode representar mais trabalho do que uma fila contendo mil pequenas atualizações. Uma pequena fila de solicitações urgentes já pode ser muito antiga. A observação útil conecta o backlog ao custo do serviço, à capacidade de conclusão e ao tempo além do qual o resultado perde seu valor comercial.
O padrão de nivelamento de carga baseado em fila da Microsoft descreve o uso de um buffer para suavizar a demanda e destaca a necessidade de controlar o processamento downstream. O padrão muda quando o trabalho é oferecido ao serviço; não fabrica rendimento. Esse limite é importante quando aplicado à desaceleração hipotética. Se o consumidor simplesmente drenar a fila o mais rápido possível sempre que a capacidade retornar, ele poderá recriar o pico original. Se os consumidores de escalonamento automático aumentarem a pressão sobre uma dependência que permanece restrita, a fila moveu a sobrecarga em vez de resolvê-la. O montante libertado da reserva necessita de um limite operacional próprio. [3]
A capacidade pode se recuperar enquanto o backlog continua crescendo
Abrir visual em tamanho real ↗Explicação e suposições
Capacidade: 60 unidades/s por 120 segundos, depois 100 unidades/s. Backlog inicial: zero. Tentativas adicionais no caso de sensibilidade: 40 unidades/s.
Ver os dados de cálculo ↗O gráfico usa um modelo de fluido intencionalmente simples. A demanda original é de oitenta unidades de trabalho por segundo. A capacidade de processamento cai para sessenta nos primeiros cento e vinte segundos e depois retorna para cem. Cada unidade tem o mesmo custo assumido. O backlog inicial é zero, o armazenamento não tem efeito limitante neste cálculo e nenhum trabalho expira ou falha permanentemente. Essas suposições tornam a aritmética transparente. Eles não descrevem o comportamento completo de um corretor, banco de dados, rede ou aplicativo real. O objetivo é mostrar como uma carga de trabalho de negócios inalterada pode se recuperar enquanto uma carga de trabalho de tentativa amplificada continua a ficar para trás.
Sem nenhuma tentativa extra de tráfego admitida nesta fila modelada, vinte unidades se acumulam a cada segundo durante a desaceleração. Depois de dois minutos, o atraso é de dois mil e quatrocentos. Quando a capacidade retornar a cem, enquanto a nova demanda permanecer em oitenta, o serviço terá vinte unidades de capacidade de processamento ociosa por segundo. A limpeza do backlog, portanto, leva mais dois minutos. A fila está vazia duzentos e quarenta segundos desde o início. A recuperação não acontece no retorno instantâneo da capacidade: o serviço primeiro tem que reembolsar o trabalho que aceitou enquanto era mais lento do que as suas chegadas.
Agora adicione quarenta unidades de tentativa por segundo ao longo do intervalo exibido. Este é um caso de sensibilidade, não uma previsão de um algoritmo de nova tentativa específico. As chegadas passam a ser cento e vinte contra sessenta durante a desaceleração, de modo que sete mil e duzentas unidades se acumulam no ponto de dois minutos. Depois que a capacidade volta a cem, as chegadas ainda excedem as conclusões em vinte. Em seis minutos, o atraso atingiu doze mil, em vez de esgotar-se. A demanda extra nesta comparação é mantida constante para isolar o seu efeito. Uma verdadeira população de novas tentativas muda com prazos, espera, conclusões bem-sucedidas e os controles que o aplicativo aplica.
Os dois rastreamentos são calculados a partir da mesma regra: o backlog não pode ser negativo e muda com o trabalho admitido menos o trabalho concluído. Os seus diferentes resultados não provam que cada nova tentativa é prejudicial. Uma tentativa bem escolhida após um breve fracasso independente pode recuperar uma tarefa valiosa. Os rastreamentos mostram por que uma tentativa precisa ser avaliada em relação à capacidade disponível. Quando o serviço restrito não consegue processar a carga adicional, mais persistência pode prolongar o período em que ninguém recebe um resultado em tempo hábil. A redução do tráfego extra pode ser uma ação de recuperação mesmo enquanto a dependência subjacente ainda está sendo reparada.
A distinção entre carga oferecida e admitida é essencial. Um limitador pode ver um grande número de solicitações, mas permitir que apenas algumas entrem na fila de trabalho. As tentativas rejeitadas ainda custam algo no limite, portanto o caminho de admissão deve ser barato o suficiente para operar sob pressão. Eles não deveriam realizar a mesma chamada de dependência dispendiosa apenas para decidir se a rejeitariam. Ao mesmo tempo, uma rejeição barata não é uma tarefa concluída do cliente. O serviço deve observar separadamente a demanda, as admissões, as rejeições e os encerramentos úteis, para que uma aparente redução no crescimento da fila não seja confundida com um cumprimento bem-sucedido.
A idade da fila adiciona a dimensão de tempo ausente. Suponha que um determinado relatório seja útil apenas antes de uma reunião de decisão. Processá-lo após a reunião pode ter pouco valor, mesmo que o sistema eventualmente reporte sucesso. Manter esse trabalho indefinidamente pode atrasar tarefas mais recentes que ainda são importantes. Porém, a expiração deve ser uma decisão de negócios com um resultado visível, em vez de excluir silenciosamente o trabalho para melhorar um gráfico. O chamador precisa saber se a solicitação foi aceita para conclusão, recusada, substituída ou expirada. Uma fila estável alcançada através do abandono do seu contrato não é um serviço recuperado.
O mesmo raciocínio complica a prioridade. Dar prioridade às tarefas urgentes pode proteger resultados importantes, mas um fluxo permanente de trabalho urgente pode privar todo o resto. A justiça entre locatários, operações e classes de carga de trabalho precisa de uma política explícita. Uma única fila global, primeiro a entrar, primeiro a sair, pode ser fácil de operar e, ao mesmo tempo, fornecer um isolamento deficiente. Muitas filas pequenas podem melhorar a separação e, ao mesmo tempo, aumentar a complexidade do monitoramento e do agendamento. A escolha útil depende de quais partes partilham um recurso escasso e de quais promessas a organização pode defender quando a procura total não pode ser satisfeita imediatamente.
4. Construa um limite que a sobrecarga não possa ultrapassar
Quatro limites diferentes, um serviço
Abrir visual em tamanho real ↗Explicação e suposições
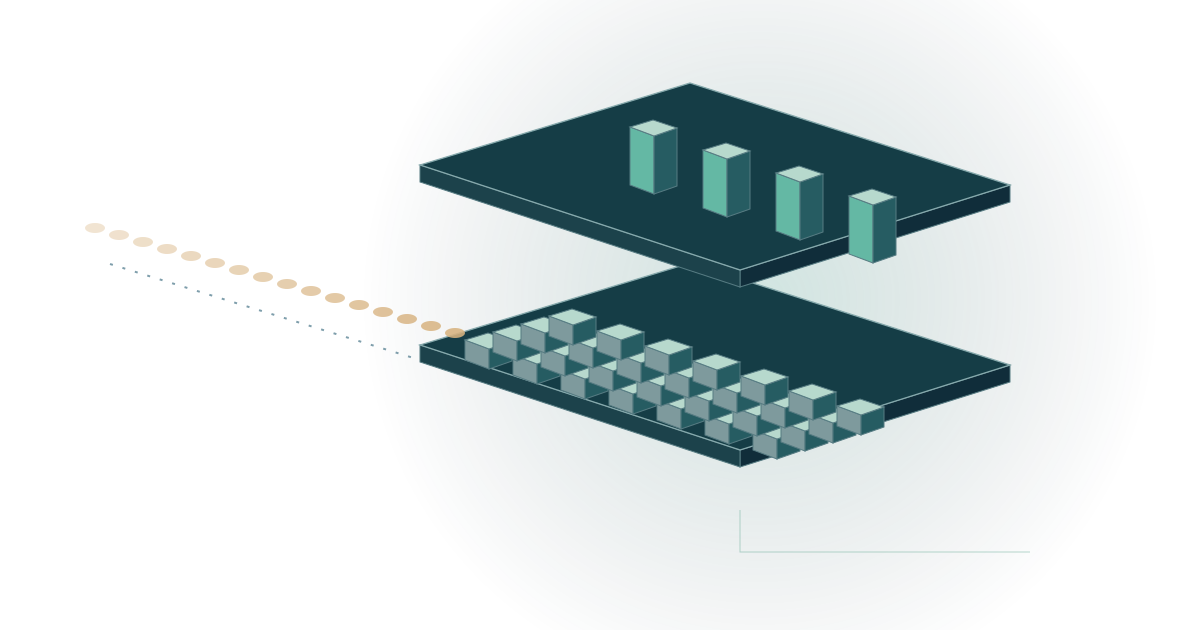
Admissão — Aceitar, rejeitar ou adiar de forma barata; preservar a identidade da operação. · Esperando trabalho — Armazenamento vinculado e idade útil; separar a demanda ao vivo do replay. · Execução ativa — Limite o trabalho real de dependência durante o voo, não apenas os chamadores em espera. · Dependência — Respeite a sua capacidade; liberar o trabalho de recuperação em uma taxa controlada.
A visão isométrica separa quatro preocupações que muitas vezes são compactadas em uma caixa de serviço: admissão, espera, execução ativa e dependência downstream. Cada camada possui um recurso escasso diferente. O caminho de admissão deve tomar uma decisão rápida. O buffer possui armazenamento finito e uma distribuição de idade. Os trabalhadores consomem memória, slots de conexão e tempo de execução. A dependência tem sua própria capacidade e limite de permissão. Tornar essas camadas visíveis ajuda a explicar por que aumentar a contagem de trabalhadores não equivale a aumentar a capacidade de todo o serviço. Um limite em uma camada pode ser superado quando a próxima camada toma emprestado de um pool compartilhado ilimitado.
Consideremos um trabalhador que se limita a um número modesto de trabalhos ativos, mas permite que cada trabalho abra muitas chamadas downstream simultâneas. O limite de nível superior parece responsável, mas o recurso que importa está a ser multiplicado abaixo dele. O mesmo problema ocorre quando um tempo limite libera uma permissão em nível de aplicativo antes que a operação subjacente tenha realmente parado de consumir a dependência. O limitador conta uma coisa enquanto o recurso paga outra. O projeto deve identificar o momento em que a licença é adquirida, o trabalho que ela abrange e a observação que justifica sua liberação.
O isolamento é útil porque o trabalho não relacionado não deve perder toda a sua capacidade para a dependência mais lenta. Pools separados ou permissões de simultaneidade podem impedir que uma integração com falha ocupe os recursos necessários para uma integração saudável. Isso não é grátis. As partições podem deixar a capacidade ociosa enquanto outra partição está ocupada, e muitas partições podem dificultar o ajuste do sistema. O valor é um limite de falha mais previsível. A escolha deve ser explicada em termos de quais cargas de trabalho podem afetar umas às outras, em vez de apresentar anteparas como uma instrução universal para criar uma fila e um pool de threads separados para cada função.
Um disjuntor toma uma decisão diferente de uma política de nova tentativa. Ele pode interromper temporariamente as tentativas de um recurso com probabilidade suficiente de falhar e permitir que análises controladas avaliem a recuperação. O padrão da Microsoft descreve essa separação. Para o serviço hipotético, a questão interessante é o que acontece em torno do disjuntor: se as tentativas bloqueadas consomem um orçamento de repetição, se o trabalho de fallback utiliza a mesma dependência com falha e se a população de sondagem permanece limitada em todas as instâncias. Um disjuntor desenhado em um diagrama de arquitetura não estabelece por si só os comportamentos circundantes. [4]
Uma alternativa pode acidentalmente piorar a situação. Se uma falta de cache enviar todas as solicitações para a dependência original, um caminho de cache aparentemente resiliente poderá concentrar a carga durante um período de baixa taxa de acertos. Se um provedor alternativo tiver uma cota menor, alternar todos os chamadores de uma vez poderá transferir o incidente. Se uma resposta degradada for cara de calcular, ela poderá não preservar capacidade suficiente para ser útil. Um fallback deve ser avaliado como outra carga de trabalho com as suas próprias dependências e condições de correção. Seu nome não é evidência de que seja mais barato, mais seguro ou esteja disponível na escala do caminho primário falido.
Existem também tarefas para as quais informações obsoletas são inaceitáveis. Retornar um resultado informativo mais antigo com um carimbo de data/hora visível pode ser uma degradação razoável para alguns leitores. Usar uma decisão de autorização antiga ou apresentar um estado de negócio desatualizado como atual pode ser um risco diferente. A aplicação precisa decidir quais partes do resultado podem ser degradadas, como essa condição é comunicada e quais operações devem ser recusadas. Preservar a disponibilidade ocultando a incerteza pode prejudicar os negócios, mesmo quando melhora a aparência do painel de taxa de erros. A resposta à falha deve preservar um relato verdadeiro do que o serviço sabe.
O tratamento dado pelo Google à sobrecarga discute respostas degradadas e a necessidade de rejeitar o trabalho quando mesmo uma resposta reduzida não pode ser atendida. Isso fornece um contexto útil para uma escolha de design que, de outra forma, poderia soar derrotista: recusar algumas solicitações pode proteger a capacidade de concluir outras. Ele não escolhe as prioridades de negócios para o serviço hipotético. Essas prioridades exigem um contrato explícito sobre quais tarefas podem esperar, quais podem degradar-se e quais devem falhar rapidamente. O mecanismo técnico precisa então de fazer cumprir esse contrato, em vez de simplesmente registá-lo num documento. [5]
5. A retirada altera o tempo; jitter muda de empresa
Dois clientes podem ter atrasos individualmente sensíveis e ainda assim chegarem juntos. Se uma grande população falhar no mesmo momento e todos os membros esperarem o mesmo intervalo, a sua próxima onda pode permanecer sincronizada. Um atraso crescente altera o espaçamento entre as ondas sem necessariamente dispersar os membros de cada onda. Jitter introduz variação em seu tempo. A ideia importante não é a aleatoriedade como um acréscimo decorativo a uma fórmula. Está a evitar uma população em recuperação que se apresenta repetidamente como uma explosão coordenada. A distribuição e os limites necessários devem se adequar ao protocolo, aos prazos e à carga de trabalho observada.
A discussão da AWS sobre espera exponencial e jitter ilustra por que o tempo determinístico de novas tentativas pode deixar grupos de trabalho. Isso apoia o mecanismo de temporização, não uma escolha de parâmetro universal para outro serviço. Na aplicação hipotética, um atraso aleatório mais longo pode distribuir tentativas, mas também levar algumas além do prazo útil do chamador. Um intervalo mais curto pode caber no prazo, mas faz muito pouco para reduzir a sincronização. O design precisa de ambas as restrições. Não deve tratar o nome de um algoritmo escolhido como prova de que cada atraso gerado é apropriado para a tarefa. [6]
Um loop de nova tentativa também precisa de uma interpretação da resposta. Uma falha de autenticação, uma regra de negócio rejeitada e um limite temporário de capacidade não exigem o mesmo comportamento. A repetição de uma solicitação inválida inalterada geralmente não pode reparar as informações que a tornaram inválida. Uma resposta de limitação pode fornecer orientação de tempo, mas o chamador ainda precisa respeitar seu próprio prazo e permissão agregada. Uma falha de conexão pode deixar a execução incerta. A classificação deve levar a uma decisão sobre a operação, e não apenas a uma pesquisa que atribui a cada exceção outro número de tentativas.
O cronograma de tentativas deve incluir o tempo gasto realizando trabalho útil, aguardando uma resposta e aguardando antes de outra tentativa. Uma política pode parecer curta quando seus atrasos são listados separadamente, mas exceder todo o tempo permitido para a tarefa, uma vez incluída a execução. Também deve levar em conta as tentativas sobrepostas, se o aplicativo permitir. A especulação paralela às vezes pode reduzir a latência, mas gasta capacidade adicional para isso. Sob sobrecarga, esse compromisso pode ser particularmente caro. Uma organização deve saber quando o serviço faz essa escolha, quais operações se qualificam e o que interrompe o trabalho extra.
A programação não é a única fonte de sincronização. Pesquisas periódicas, atualização de token, início de lote agendado e uma frota de processos reiniciados após um evento compartilhado podem concentrar a atividade. A interrupção hipotética poderia, portanto, ocorrer novamente mesmo depois que o loop de nova tentativa explícito fosse melhorado. A investigação útil pergunta quais relógios são compartilhados pela carga de trabalho e quais ações dispendiosas eles acionam. Distribuir o trabalho em segundo plano pode ajudar, mas prazos, horários comerciais e janelas de serviços externos podem restringir essa liberdade. Uma solução correta altera o padrão de chegada relevante, mantendo ao mesmo tempo o propósito da tarefa agendada.
O chamador que pressiona o botão novamente
As pessoas podem ser outra camada de repetição. Uma tela que gira sem explicar se uma solicitação foi aceita convida ao reenvio. Um botão desabilitado pode reduzir duplicatas acidentais, mas não pode estabelecer o estado do servidor após uma resposta perdida. Uma referência de operação durável e uma visão clara do status podem fornecer ao leitor uma maneira de inspecionar a primeira solicitação em vez de criar outra. A interface deve distinguir a espera por uma operação aceita da solicitação ao servidor para iniciar uma nova operação. Essa distinção torna-se especialmente valiosa quando um prazo interativo curto antecede um processo assíncrono mais longo.
O texto é importante porque o software está fazendo uma promessa. Dizer que um pedido falhou quando o seu resultado é desconhecido encoraja uma acção diferente de dizer que o processamento foi aceite e o seu estado está a ser verificado. Nenhuma das mensagens deve alegar uma certeza que o sistema não possui. A visualização do status também deve evitar se tornar uma fonte de pesquisa não controlada durante o incidente. Escolher o intervalo, armazenar o status em cache quando apropriado e limitar as atualizações repetidas fazem parte do mesmo projeto de capacidade. Uma experiência de usuário útil ajuda as pessoas a recuperarem suas intenções sem transformar sua incerteza em outra onda de trabalho.
6. O tráfego de recuperação precisa de uma rota para casa
Um serviço orientado a filas introduz outra distinção: o processamento bem-sucedido e a confirmação bem-sucedida são eventos separados. O efeito comercial pode ser concluído antes que o corretor saiba que a mensagem pode ser removida. Se a confirmação for perdida, o sistema poderá ver a mensagem novamente. O Azure Service Bus documenta transferências, bloqueios e liquidação como partes separadas da entrega. A consequência arquitetônica é conectar a identidade de processamento da mensagem à operação de negócios e lidar deliberadamente com entregas repetidas. Aumentar o limite de contagem de entrega não estabelece que a execução repetida seja segura. [7]
O trabalhador também precisa reconhecer o trabalho que não se tornará válido através da repetição. Uma carga útil malformada, uma versão de operação não suportada ou um pré-requisito permanentemente ausente pode exigir correção ou investigação. Devolvê-lo indefinidamente à fila ativa pode gastar capacidade sem aumentar a chance de sucesso. Um caminho de falha separado pode manter a carga de trabalho normal em movimento, mas esse caminho precisa de um proprietário e de uma consequência visível. Uma fila de mensagens mortas cujo conteúdo nunca é examinado não é uma estratégia de recuperação; é um acúmulo de promessas não resolvidas que estão fora do gráfico de rendimento principal.
A documentação de mensagens mortas do Service Bus da Microsoft explica a função da subfila secundária e a necessidade dos aplicativos lidarem com suas mensagens. A escolha importante para o serviço hipotético é o que acontece antes de qualquer reenvio. A equipe precisa estabelecer se o defeito subjacente foi corrigido, se a intenção comercial original ainda é atual e se uma tentativa anterior já causou efeito. Uma repetição em massa que ignora essas questões pode converter incertezas antigas em carga nova. O procedimento de recuperação deve ser capaz de selecionar o trabalho, em vez de tratar cada mensagem armazenada como igualmente segura para ser executada novamente. [8]
Quando a capacidade retorna, a demanda ativa e o trabalho de recuperação histórica competem. Um serviço que esgota todas as tarefas antigas na taxa máxima disponível pode causar uma segunda interrupção aos usuários atuais. Um serviço que reserva tudo para novos trabalhos pode nunca eliminar o backlog. A taxa de libertação para o trabalho de recuperação necessita, portanto, de uma política ligada à capacidade não utilizada real e à prioridade do negócio. Pode ser ajustado conforme o comportamento da dependência muda. O ponto essencial é que a recuperação é uma carga de trabalho por si só, e não uma categoria especial isenta dos limites aplicados ao tráfego normal.
A decisão de recuperação também possui uma condição de parada. Uma reprodução pode precisar ser pausada quando a latência aumenta, quando a solicitação ativa mais antiga excede sua idade útil, quando a detecção de duplicatas encontra um padrão inesperado ou quando uma dependência começa a ser limitada novamente. Os sinais relevantes dependem do serviço. O que importa é que a pessoa ou mecanismo que libera o trabalho antigo possa observá-lo e agir antes que o buffer se torne a fonte de outro surto. Um comando de repetição sem caminho de feedback oferece persistência, mas pouco controle sobre suas consequências.
Preservar a proveniência torna esse feedback mais útil. Uma operação deve ser rastreável em seu primeiro envio, tentativas posteriores, entregas em fila e qualquer correção manual. Os identificadores não precisam expor conteúdo confidencial para conseguir isso. Eles precisam de um relacionamento estável com a intenção comercial e de contexto de configuração suficiente para explicar a política sob a qual cada tentativa foi executada. Sem essa continuidade, uma equipe pode gastar sua resposta a incidentes decidindo se está analisando uma operação persistente, muitas solicitações novas ou uma mistura de ambas. O volume extra de registro torna-se então outra pressão de recursos, sem fornecer o entendimento necessário.
7. Procure o trabalho que está sendo feito
Um serviço pode estar ocupado, disponível e inútil ao mesmo tempo. CPU, utilização de conexão e taxa de solicitação descrevem a atividade, enquanto conclusões úteis descrevem o progresso. Nenhuma categoria substitui a outra. A observação interessante é como eles divergem. Se as tentativas aumentarem enquanto as operações únicas concluídas diminuírem, o serviço poderá estar gastando mais para conseguir menos. Se a latência melhorar apenas porque uma fração maior do trabalho foi rejeitada, o aplicativo poderá ter protegido seus recursos e ainda falhar em muitos leitores. A visão operacional deve tornar ambos os factos visíveis, em vez de escolher a métrica que conte a história mais tranquilizadora.
O denominador é particularmente importante para um aplicativo que tenta novamente. Uma taxa de sucesso no nível de tentativa pode ser distorcida pelo número de tentativas por operação. Uma taxa de conclusão no nível do usuário pode ocultar a quantidade de consumo de recursos necessária para produzir cada sucesso. Um painel útil separa a demanda original, o total de tentativas, o trabalho admitido, as operações únicas concluídas, o tempo até a conclusão útil e os resultados que permanecem incertos. Também mostra idade e classe de carga horária onde essas distinções afetam a decisão. Estas medidas descrevem diferentes questões; coletá-los só é útil quando a equipe consegue vincular uma mudança neles a uma ação.
Uma proporção de diagnóstico é a tentativa de chamadas de dependência por operação original. Outra é a parcela do escasso tempo de execução gasto em operações cujo prazo para início já expirou. Nenhum dos dois deve ser tratado como um objectivo de nível de serviço universal. São formas de tornar visível um mecanismo suspeito. A definição precisa ser precisa o suficiente para evitar considerar a recuperação de conexão inofensiva como uma execução comercial extra ou tratar uma tarefa intencionalmente assíncrona como trabalho abandonado. A medida é valiosa quando discrimina entre explicações, e não quando fornece outra linha atraente no painel de incidentes.
O custo faz parte dessa observação. As tentativas extras podem aumentar as cobranças de solicitações, o volume de registros, a rotatividade de conexões ou o consumo de computação, mesmo quando não concluem mais trabalho comercial. O custo por solicitação pode parecer melhorar se o denominador crescer com as novas tentativas, enquanto o custo por resultado útil se deteriora. A organização precisa de uma visão de custos que acompanhe a tarefa o suficiente para incluir esforços repetidos e fracassados. Nenhuma economia é reivindicada aqui. A questão é escolher um limite contabilístico que revele se uma mudança de resiliência proposta reduz o desperdício, em vez de simplesmente transferi-lo para outro serviço ou fatura.
Teste a cadeia, não apenas o loop
Uma nova tentativa bem-sucedida em um teste unitário estabelece muito pouco sobre uma frota sob falha correlacionada. Um teste controlado mais revelador altera a latência ou a capacidade de conclusão de uma dependência, mantendo a demanda original identificável. Ele observa se a tentativa de amplificação permanece limitada, se os prazos terminam o trabalho conforme pretendido e se o rendimento útil é recuperado após a perturbação. O ambiente e os limites devem tornar esse teste seguro. O objetivo não é causar um incidente de produção descontrolado para demonstrar resistência. É para desafiar a suposição específica de que tentativas extras continuam úteis quando muitos chamadores falham juntos.
Os cenários devem distinguir respostas lentas, rejeições definitivas e resultados desconhecidos. Eles devem incluir uma dependência que seja recuperada antes do prazo final do chamador e outra que não seja recuperada. Um serviço baseado em fila também deve exercer incerteza de reconhecimento, trabalho expirado e repetição deliberadamente restrita. O resultado esperado não é simplesmente que todas as tarefas enviadas sejam bem-sucedidas. Algumas tarefas devem ser recusadas ou parar de tentar. A questão significativa é se o resultado observado corresponde ao contrato, enquanto o recurso limitado permanece protegido e a organização pode explicar o que aconteceu a cada classe de trabalho.
Uma comparação precisa da mesma demanda original. Caso contrário, uma configuração que parece recuperar mais rapidamente pode simplesmente ter recebido uma carga de trabalho mais fácil. A conta deve reter o padrão de chegada, combinação de tarefas, condição de dependência e versões de configuração relevantes para o resultado. Deve distinguir exemplos calculados, como o gráfico deste artigo, de medições obtidas em um teste de corrida. Repetir uma história numérica plausível como se fosse uma referência enfraqueceria a evidência. Um pequeno modelo transparente é útil porque as suas suposições podem ser desafiadas, não porque as suas linhas suaves se assemelham a um traço de produção.
8. O sistema que pode parar de tentar
Retorne à primeira solicitação atrasada. Não precisava se tornar uma interrupção. A cadeia de falhas adquiriu força através de diversas transições: um tempo limite foi interpretado como permissão para iniciar mais trabalho; camadas multiplicaram tentativas sem um orçamento comum; o trabalho em espera escondia uma lacuna cada vez maior em termos de capacidade; e o tráfego de recuperação foi tratado como se sua urgência criasse rendimento adicional. Cada transição oferece um lugar para interromper a cadeia. O design não precisa de todos os padrões de resiliência possíveis. Necessita de controlos nos pontos onde este serviço pode transformar a incerteza numa carga extra ou num efeito comercial repetido.
Há circunstâncias em que outra tentativa é exatamente a resposta certa. Uma breve falha independente pode desaparecer, uma leitura segura pode ser concluída rapidamente em outra rota ou um reenvio limitado pode recuperar uma tarefa valiosa. O argumento não é contra a persistência. É pela persistência que se mantém responsável pelo tempo, pela capacidade e pelo significado da operação. Um serviço deve ser capaz de explicar porque foi feita uma tentativa, que subsídio pagou por ela e que observação impediria a tentativa seguinte. Essa explicação é mais útil do que uma declaração genérica de que as novas tentativas foram habilitadas para fins de confiabilidade.
A capacidade de recuperação mais importante pode, portanto, ser a capacidade de parar. Pare de criar tentativas quando o prazo tiver tornado o resultado inútil. Pare de emprestar capacidade de trabalho não relacionado. Pare de reproduzir um backlog quando o serviço ativo começar a sofrer. Pare de alegar falha definitiva quando o resultado da execução ainda for desconhecido. Estas são decisões diferentes e cada uma precisa de um proprietário ou mecanismo apropriado. Juntos, eles abrem espaço para a recuperação da dependência subjacente e para a organização corrigir o trabalho que resta, em vez de forçar todas as intenções não resolvidas a retornarem pelo mesmo caminho sobrecarregado.
Um serviço confiável não promete tentar para sempre. Faz uma promessa mais prática: o trabalho aceite tem um significado definido, o esforço adicional tem um limite e um fracasso produz um resultado que as pessoas podem compreender e agir. Quando essas condições se mantêm, as novas tentativas podem continuar a ser uma ferramenta útil, em vez de se tornarem uma carga de trabalho invisível sem nenhum cliente responsável. A diferença aparece mais claramente durante a recuperação. À medida que a falha original recua, o sistema tem controle suficiente sobre seu próprio comportamento para permitir que o trabalho útil seja retomado.