Fiabilité des systèmes
Quand les tentatives se transforment en panne
Un léger ralentissement peut se transformer en une panne à l’échelle du système lorsque chaque couche tente de se rétablir d’elle-même. Suivez la chaîne et les limites qui peuvent l'arrêter.
Suivez la chaîne des échecs
- 1. Un petit retard acquiert une seconde vie
- 2. La multiplication se fait entre équipes
- 3. Les salles d’attente ne créent pas de capacité
- 4. Construisez une limite à travers laquelle la surcharge ne peut pas emprunter
- 5. Le backoff modifie le timing ; jitter change de société
- 6. Le trafic de récupération a besoin d’un chemin de retour
- 7. Recherchez le travail qui est effectué
- 8. Le système qui est autorisé à arrêter d'essayer
Une intention, vingt-sept tentatives possibles
Ouvrir le visuel en taille réelle ↗Explication et hypothèses
Branchement illustratif dans le pire des cas : trois couches, chacune permettant trois tentatives totales, y compris l'original. Pas de succès ou d’annulation précoce ; le trafic réel dépend de la mise en œuvre. Les zones en anneau ne constituent pas une mesure de la charge de travail.
La première requête ayant échoué est souvent la partie la moins intéressante d’une panne. Une dépendance prend plus de temps que prévu, un appelant abandonne l'attente et l'application réessaye. Cela ressemble à une mesure de récupération judicieuse. La difficulté apparaît lorsque des milliers d’autres appelants arrivent à la même conclusion, que plusieurs couches font leurs propres tentatives et que le travail original est toujours en cours. Le système consacre désormais une part croissante de sa capacité à récupérer de la charge créée par ses mécanismes de récupération. Rien dans une boucle de nouvelle tentative individuelle ne doit paraître manifestement déraisonnable pour que le comportement combiné devienne destructeur.
Considérons un service de statut de commande explicitement hypothétique. Il dispose normalement de suffisamment de capacité pour son travail entrant, mais une dépendance en aval ralentit pendant deux minutes. Les requêtes restent en cours de traitement plus longtemps, le délai d'attente de l'appelant commence à expirer et une bibliothèque cliente commence une autre tentative. Un service externe a également une politique de nouvelle tentative. Une interface utilisateur propose un bouton de réessai car sa propre date limite est dépassée. La demande des entreprises a à peine changé, mais la dépendance voit davantage de tentatives de travail, précisément alors qu'elle peut en accomplir moins. Cet article suit cette chaîne, puis examine les endroits où un design peut l'interrompre. Le scénario et chaque exemple numérique sont illustratifs et ne constituent pas le récit d'un incident client MGCA ou une référence mesurée.
Une nouvelle tentative est une nouvelle demande de ressources, même si elle représente une ancienne intention. Cette distinction est le point de départ pour comprendre l’échec. L'entreprise peut toujours souhaiter une mise à jour de son statut, une demande soumise ou un rapport complété. L'infrastructure peut traiter plusieurs tentatives pour le produire. Si les tableaux de bord comptent les demandes sans les connecter à l’opération sous-jacente, l’activité supplémentaire peut ressembler à une augmentation de la demande des clients. Si le succès est mesuré par tentative plutôt que par résultat utile, le service peut également apparaître plus sain que l'expérience de la personne qui l'attend.
1. Un petit retard acquiert une seconde vie
Un timeout répond à une question locale : combien de temps cet appelant va-t-il attendre ? Il ne permet pas, en soi, de déterminer si l'opération à distance s'est arrêtée, a échoué avant son exécution ou s'est terminée sans délivrer son accusé de réception. Ce sont des résultats différents. Pour une lecture, répéter la requête peut principalement consommer des ressources. Pour une écriture, un résultat incertain peut également créer un problème d’exactitude. Le système de réception a peut-être déjà validé la modification. Le désir de l'appelant de recevoir une réponse définitive ne rend pas une autre exécution sûre. La protection de la capacité et l’exactitude commerciale doivent donc être considérées ensemble, plutôt que d’attribuer des tentatives à une couche de transport et de supposer que le reste de l’application n’est pas affecté.
La première réponse à un ralentissement est souvent d’augmenter le délai d’attente. Cela peut réduire les fausses pannes lorsque la variation normale était confondue avec une panne. Cela peut également permettre à davantage de requêtes d’occuper des ressources plus longtemps. Réduire le délai d'attente crée le compromis inverse : les appelants libèrent leur état d'attente plus tôt, mais peuvent lancer des tentatives de remplacement pendant que le travail précédent reste actif. Aucune des deux directions n’est intrinsèquement correcte. La question utile est de savoir quelles ressources restent occupées, quel travail s’arrête réellement et quel est le rapport entre le délai choisi et la valeur de l’achèvement de la tâche. Changer un chiffre sans répondre à ces questions peut faire bouger la pression plutôt que de la supprimer.
Il y a aussi plus d'une horloge. L'établissement d'une connexion, la résolution d'un nom, l'obtention d'un jeton d'identité, l'attente d'une connexion groupée et la réception de la réponse peuvent chacun consommer une partie du temps disponible de l'appelant. Un délai d'attente de requête qui exclut une attente antérieure peut donner une impression trompeuse de l'opération totale. À l’inverse, des allocations généreuses indépendamment à chaque étape peuvent produire un retard global bien au-delà de la promesse faite à l’utilisateur. Une conception nécessite un compte rendu cohérent du temps écoulé, y compris le temps passé avant le début de l'appel à distance et entre les tentatives. La limite importante est l’ensemble de la tâche, et non la minuterie la plus facile à configurer.
Dans le service hypothétique, imaginez que la page visible cesse d'attendre après cinq secondes tandis qu'un client interne est autorisé à continuer pendant vingt secondes. Ces valeurs ne sont pas des paramètres recommandés. Ils exposent un problème de propriété. Pendant une partie de cette période, le service peut travailler sur une demande dont le lecteur d'origine a déjà quitté. Si la page soumet une nouvelle opération, l'ancienne œuvre et la nouvelle œuvre entrent en compétition. Si l'annulation se propage, le composant récepteur doit encore définir ce qu'il peut annuler en toute sécurité. Arrêter une attente réseau et annuler une transaction validée ne sont pas la même capacité. Un délai peut mettre fin à l’utilité d’un résultat sans en inverser les effets.
Le premier point d'interruption est donc une échéance qui a un propriétaire. Un composant doit savoir combien de temps il reste à l'opération, si une autre tentative peut vraisemblablement se terminer pendant cette opération et ce qui se passe lorsque ce temps est épuisé. La réponse peut être un échec évident, une opération asynchrone conservée avec une référence d'état ou un résultat marqué comme incomplet. Il ne doit pas s'agir d'un transfert invisible du même travail dans une autre boucle de nouvelle tentative illimitée. Une politique de récupération est utile lorsqu'elle améliore les chances d'obtenir un résultat valide dans le cadre des contraintes réelles de la tâche.
Les conseils techniques d'Amazon traitent des délais d'attente, des délais d'attente, de l'instabilité et du risque qu'un appel expiré ait déjà produit des effets secondaires. Microsoft décrit l'anti-modèle de nouvelle tentative associé : des tentatives fréquentes peuvent empêcher la récupération d'un service en difficulté. Ces sources soutiennent le mécanisme général, plutôt que de valider les chiffres particuliers de cet article. Le raisonnement de conception qui suit applique ce mécanisme à un service délibérément simplifié afin que les conséquences restent inspectables. [1] [2]
2. La multiplication se fait entre équipes
Trois tentatives semblent modestes. Trois couches permettant chacune trois tentatives au total peuvent être très différentes. Dans le cas spécifique du pire cas, selon lequel chaque tentative externe entraîne toutes les tentatives internes et qu'aucune ne réussit rapidement, la dépendance la plus profonde peut recevoir vingt-sept tentatives pour une opération originale. Il s'agit d'une multiplication à travers la hiérarchie des appels, et non d'une affirmation selon laquelle chaque échec produit automatiquement ce décompte. L'annulation, les délais, le succès précoce, l'état du circuit et la propriété réelle de la nouvelle tentative peuvent le réduire. Le but du calcul est d’exposer une interaction qu’il est facile de manquer lorsque chaque composant est examiné indépendamment.
La terminologie compte ici. Un paramètre décrit comme trois tentatives peut signifier une tentative originale plus trois autres, alors que trois tentatives incluent l'original. Confondre ces définitions modifie le calcul avant qu'aucun détail d'implémentation n'y entre. Une discussion sur l'architecture doit noter le nombre total de tentatives autorisées à chaque limite et identifier quel composant les démarre. Il doit également inclure le comportement fourni par les bibliothèques clientes, les passerelles et l'infrastructure. Un diagramme qui montre uniquement le code d'application peut omettre le mécanisme de nouvelle tentative qui domine le trafic. Le composant qui cache une erreur à son appelant contribue toujours à la charge de travail du système.
La cause organisationnelle est compréhensible. Chaque équipe souhaite que son propre service tolère une brève interruption. Une bibliothèque partagée adopte une politique standard. Une passerelle ajoute une autre couche de protection. Un travailleur traite une exception comme une raison pour abandonner et recevoir à nouveau le message. Aucun de ces choix ne doit être imprudent. L’échec apparaît parce que les politiques partagent une dépendance sans partager un budget. La résilience locale est devenue un optimisme collectif : chaque participant suppose qu’une autre tentative est abordable, alors qu’aucun participant n’est responsable du nombre total de tentatives que l’opération commerciale peut générer.
Le diagramme radial à l'ouverture le rend visible. Ses anneaux représentent une opération originale, puis trois, neuf et vingt-sept tentatives aval possibles dans un modèle volontairement contraint. Les anneaux ne constituent pas un trafic mesuré et leurs superficies ne constituent pas des estimations de performances. Ils constituent un moyen d’inspecter l’hypothèse de branchement sans dessiner un autre paysage d’application rectangulaire. Suivez une seule intention vers l’extérieur et demandez où la nouvelle œuvre est créée. Si plusieurs couches peuvent l'étendre indépendamment, le fait de vérifier uniquement le nombre maximum de tentatives du client final n'établira pas la charge maximale que l'ensemble de la route peut imposer.
Une réponse pratique consiste à rendre explicite la propriété des nouvelles tentatives à la limite où l'application dispose de suffisamment de contexte pour juger de l'opération. Cela ne signifie pas que chaque système doit centraliser toute la logique de résilience en un seul endroit. Un transport peut raisonnablement récupérer une connexion interrompue tandis qu'une application gère une tâche plus longue. L’exigence est que leur comportement combiné soit compris et délimité. Une couche inférieure ne doit pas redémarrer silencieusement une action commerciale complète une fois que la couche supérieure estime avoir épuisé la capacité de la tâche. La frontière entre la reconnexion, le renvoi et la réexécution doit être visible à la fois dans la conception et dans l'observation.
Un budget de nouvelle tentative ajoute une deuxième limite au-delà du maximum par demande. L'application peut limiter la quantité globale de travail supplémentaire qu'elle introduit en cas de panne. L'unité de comptabilisation doit être choisie délibérément : demandes, tentatives concurrentes, temps écoulé, coût pondéré ou une combinaison. Une lecture en cache bon marché et un rapport coûteux ne sont pas nécessairement des jetons interchangeables. Le mécanisme devrait également définir ce qui se passe lorsque le budget est vide. Le simple fait de déplacer les tentatives rejetées vers une file d'attente privée préserve la pression tout en la masquant du limiteur d'origine. Un budget utile modifie le comportement qui atteint la ressource contrainte.
Il n’existe pas de pourcentage universel qui rende un tel budget correct. La capacité de récupération disponible, le contrat de dépendance, la valeur de la tâche et le comportement en cas d'échec diffèrent. Un service peut réserver une marge étroite pour de courtes erreurs passagères tout en refusant de multiplier le travail coûteux en cas de panne persistante. Un autre pourrait reporter les tâches éligibles à un processus en arrière-plan contrôlé séparément. Ce qui compte, c'est que la politique reste pertinente lorsque le système est mis à rude épreuve, lorsque les succès sont rares et lorsque plusieurs appelants échouent ensemble. Un budget dont la reconstitution dépend du succès nécessite une interprétation explicite de cette période de faible succès, plutôt qu’un blocage accidentel ou une dérogation d’urgence illimitée.
Une tentative ratée n’est pas une nouvelle instruction commerciale
Pour un service capable d'écrire, l'identité de l'opération doit survivre à la tentative. Si un client génère un nouvel identifiant commercial à chaque fois qu'il renvoie la même intention, un destinataire peut raisonnablement traiter les demandes comme des opérations différentes. S'il réutilise un identifiant sans vérifier le contenu associé, la même clé peut être attachée à des modifications sensiblement différentes. Une conception d’idempotence nécessite donc plus qu’un champ nommé ID de demande. Il nécessite une portée, une relation avec l'action envisagée, une période de conservation et une réponse définie lorsqu'un identifiant répété arrive avec un contenu incompatible.
Le résultat est tout aussi important. Si le destinataire peut identifier une opération terminée mais ne peut pas récupérer son résultat, l'appelant peut rester incertain même si une exécution en double est empêchée. Le service doit décider s’il peut renvoyer le résultat précédent, fournir une référence de statut ou exiger une enquête. L'agencement correct dépend de l'opération et de ses exigences en matière de traitement des informations. La distinction générale est stable : reconnaître une instruction ancienne, prévenir un autre effet et expliquer l’effet existant sont des capacités liées, mais elles ne sont pas automatiquement délivrées par le même mécanisme.
3. Les salles d’attente ne créent pas de capacité
Une file d'attente peut faciliter le contrôle d'une charge de travail. Il sépare l'acceptation de l'exécution et donne aux consommateurs la possibilité de traiter le travail à un rythme durable. Cela peut également cacher une promesse croissante que le service ne peut pas tenir. La profondeur de la file d’attente n’est donc ni une mesure de réussite ni une explication en soi. Une file d'attente contenant dix rapports lents peut représenter plus de travail qu'une file d'attente contenant mille petites mises à jour. Une courte file de demandes urgentes peut déjà être trop ancienne. L'observation utile relie le retard au coût du service, à la capacité d'exécution et au délai au-delà duquel le résultat perd sa valeur commerciale.
Le modèle de nivellement de charge basé sur la file d'attente de Microsoft décrit l'utilisation d'un tampon pour lisser la demande et souligne la nécessité de contrôler le traitement en aval. La tendance change lorsque du travail est proposé au service ; il ne fabrique pas de débit. Cette limite est importante lorsqu’on l’applique au ralentissement hypothétique. Si le consommateur se contente de vider la file d’attente le plus rapidement possible dès que la capacité revient, il peut recréer la hausse initiale. Si les consommateurs d’autoscaling augmentent la pression sur une dépendance qui reste contrainte, la file d’attente a déplacé la surcharge plutôt que de l’avoir résolue. Le montant libéré du tampon nécessite sa propre limite de fonctionnement. [3]
La capacité peut se rétablir tandis que le retard ne cesse de croître
Ouvrir le visuel en taille réelle ↗Explication et hypothèses
Capacité : 60 unités/s pendant 120 secondes, puis 100 unités/s. Retard initial : zéro. Tentatives supplémentaires dans le cas de sensibilité : 40 unités/s.
Afficher les données de calcul ↗Le graphique utilise un modèle fluide intentionnellement simple. La demande initiale est de quatre-vingts unités de travail par seconde. La capacité de traitement tombe à soixante pendant les cent vingt premières secondes, puis revient à cent. Chaque unité a le même coût supposé. Le retard initial est nul, le stockage n’a aucun effet limitant dans ce calcul et aucun travail n’expire ou n’échoue définitivement. Ces hypothèses rendent l'arithmétique transparente. Ils ne décrivent pas le comportement complet d’un véritable courtier, d’une base de données, d’un réseau ou d’une application. L’objectif est de montrer comment une charge de travail métier inchangée peut récupérer alors qu’une charge de travail de tentative amplifiée continue de prendre du retard.
En l'absence de trafic de tentative supplémentaire admis dans cette file d'attente modélisée, vingt unités s'accumulent chaque seconde pendant le ralentissement. Au bout de deux minutes, l'arriéré est de deux mille quatre cents. Une fois que la capacité revient à cent alors que la nouvelle demande reste à quatre-vingts, le service dispose de vingt unités de capacité de traitement disponible par seconde. Il faudra donc encore deux minutes pour rattraper le retard. La file d'attente est vide à deux cent quarante secondes du départ. La récupération ne se produit pas au moment du retour de la capacité : le service doit d'abord rembourser le travail qu'il a accepté alors qu'il était plus lent que ses arrivées.
Ajoutez maintenant une hypothèse de quarante unités de tentative par seconde tout au long de l'intervalle affiché. Il s’agit d’un cas de sensibilité et non d’une prédiction d’un algorithme de nouvelle tentative particulier. Les arrivées deviennent cent vingt contre soixante pendant le ralentissement, donc sept mille deux cents unités s'accumulent au pas de deux minutes. Une fois la capacité revenue à cent, les arrivées dépassent encore de vingt les achèvements. En six minutes, l'arriéré a atteint douze mille au lieu de s'épuiser. La demande supplémentaire dans cette comparaison est maintenue constante pour isoler son effet. Une véritable population de nouvelles tentatives change en fonction des délais, des délais, des réussites et des contrôles appliqués par l'application.
Les deux traces sont calculées à partir de la même règle : le backlog ne peut pas être négatif, et il évolue avec le travail admis moins le travail réalisé. Leurs résultats différents ne prouvent pas que chaque nouvelle tentative soit nuisible. Une tentative bien choisie après un bref échec indépendant peut permettre de récupérer une tâche précieuse. Les traces montrent pourquoi une tentative doit être évaluée par rapport à la capacité disponible. Lorsque le service contraint ne peut pas traiter la charge supplémentaire, une plus grande persévérance peut prolonger la période pendant laquelle personne ne reçoit de résultat en temps opportun. Réduire le trafic supplémentaire peut constituer une action de récupération même si la dépendance sous-jacente est encore en cours de réparation.
La distinction entre charge offerte et charge admise est essentielle. Un limiteur peut voir un grand nombre de requêtes mais n'autoriser que certaines d'entre elles à entrer dans la file d'attente de travail. Les tentatives rejetées coûtent quand même quelque chose à la frontière, de sorte que la voie d’admission doit être suffisamment peu coûteuse pour fonctionner sous pression. Ils ne devraient pas effectuer le même appel de dépendance coûteux simplement pour décider de le rejeter ou non. Dans le même temps, un refus bon marché n’est pas une tâche accomplie par le client. Le service doit observer séparément la demande, les admissions, les refus et les achèvements utiles afin qu'une réduction apparente de la croissance de la file d'attente ne soit pas confondue avec une exécution réussie.
L'âge de la file d'attente ajoute la dimension temporelle manquante. Supposons qu'un rapport particulier ne soit utile qu'avant une réunion de décision. Le traiter après la réunion peut avoir peu de valeur, même si le système finit par signaler un succès. Conserver ce travail indéfiniment peut retarder les nouvelles tâches qui sont encore importantes. L'expiration doit cependant être une décision commerciale avec un résultat visible, plutôt que de supprimer silencieusement un travail pour améliorer un graphique. L'appelant doit savoir si la demande a été acceptée pour finalisation, refusée, remplacée ou autorisée à expirer. Une file d'attente stable obtenue grâce à l'abandon de son contrat n'est pas un service récupéré.
Le même raisonnement complique la priorité. Donner la priorité aux tâches urgentes peut protéger des résultats importants, mais un flux permanent de travaux urgents peut affamer tout le reste. L'équité entre les locataires, les opérations et les classes de charge de travail nécessite une politique explicite. Une file d’attente mondiale unique premier entré, premier sorti peut être facile à gérer tout en offrant une mauvaise isolation. De nombreuses petites files d'attente peuvent améliorer la séparation tout en augmentant la complexité de la surveillance et de la planification. Le choix utile dépend des parties qui partagent une ressource rare et des promesses que l’organisation peut défendre lorsque la demande totale ne peut être satisfaite immédiatement.
4. Construisez une limite à travers laquelle la surcharge ne peut pas emprunter
Quatre limites différentes, un service
Ouvrir le visuel en taille réelle ↗Explication et hypothèses
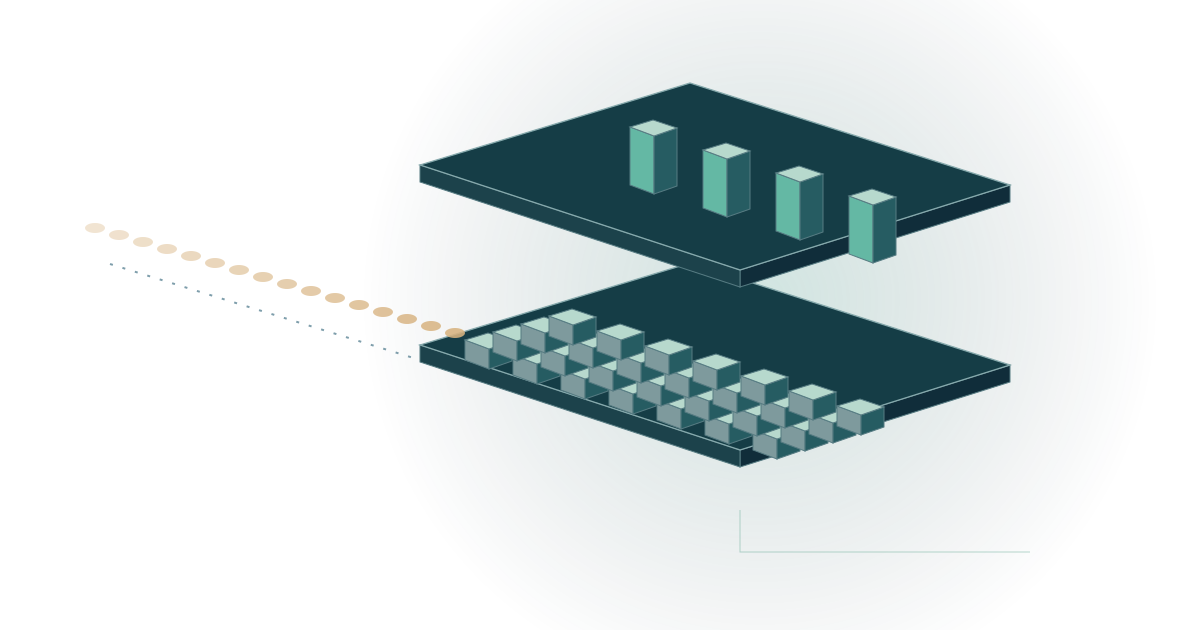
Admission — Accepter, rejeter ou différer à moindre coût ; préserver l’identité de l’opération. · Travail en attente — Stockage relié et âge utile ; séparer la demande en direct de la rediffusion. · Exécution active — Limitez le véritable travail de dépendance en vol, et pas seulement les appelants en attente. · Dépendance — Respectez sa capacité; libérer le travail de récupération à un rythme contrôlé.
La vue isométrique sépare quatre préoccupations qui sont souvent regroupées dans une seule boîte de services : l'admission, l'attente, l'exécution active et la dépendance en aval. Chaque couche possède une ressource rare différente. Le parcours d'admission doit prendre une décision rapide. Le tampon a un stockage fini et une distribution par âge. Les travailleurs consomment de la mémoire, des emplacements de connexion et du temps d'exécution. La dépendance a sa propre limite de capacité et d’autorisation. Rendre ces couches visibles permet d'expliquer pourquoi augmenter le nombre de travailleurs n'équivaut pas à augmenter la capacité de l'ensemble du service. Une limite à une couche peut être dépassée lorsque la couche suivante emprunte à un pool partagé illimité.
Prenons l'exemple d'un travailleur qui se limite à un nombre modeste d'emplois actifs mais permet à chaque emploi d'ouvrir de nombreux appels simultanés en aval. La limite supérieure semble responsable, mais la ressource qui compte est multipliée en dessous. Le même problème se produit lorsqu'un délai d'attente libère un permis au niveau de l'application avant que l'opération sous-jacente n'ait réellement cessé de consommer la dépendance. Le limiteur compte une chose tandis que la ressource en paie une autre. La conception doit identifier le moment où un permis est acquis, les travaux qu'il couvre et l'observation qui justifie sa délivrance.
L'isolement est utile car le travail indépendant ne doit pas perdre toute sa capacité au profit de la dépendance la plus lente. Des pools séparés ou des allocations de concurrence peuvent empêcher une intégration défaillante d’occuper les ressources nécessaires à une intégration saine. Ce n'est pas gratuit. Les partitions peuvent laisser une capacité inactive alors qu'une autre partition est occupée, et un trop grand nombre de partitions peut rendre le système difficile à régler. La valeur est une limite de défaillance plus prévisible. Le choix doit être expliqué en fonction des charges de travail qui peuvent s'influencer mutuellement, plutôt que de présenter les cloisons comme une instruction universelle visant à créer une file d'attente et un pool de threads distincts pour chaque fonction.
Un disjoncteur prend une décision différente d'une politique de nouvelle tentative. Il peut temporairement arrêter les tentatives sur une ressource suffisamment susceptible d'échouer et permettre à des sondes contrôlées d'évaluer la récupération. Le modèle de Microsoft décrit cette séparation. Pour le service hypothétique, la question intéressante est de savoir ce qui se passe autour du disjoncteur : si les tentatives bloquées consomment un budget de nouvelle tentative, si le travail de secours utilise la même dépendance défaillante et si la population de sondes reste limitée dans toutes les instances. Un disjoncteur dessiné dans un diagramme d'architecture n'établit pas à lui seul les comportements environnants. [4]
Une solution de repli peut accidentellement aggraver la situation. Si un échec de cache envoie chaque requête à la dépendance d'origine, un chemin de cache apparemment résilient peut concentrer la charge pendant une période de faible taux de réussite. Si un autre fournisseur a un quota inférieur, le fait de changer tous les appelants en même temps peut transférer l'incident. Si une réponse dégradée est coûteuse à calculer, elle risque de ne pas conserver suffisamment de capacité pour être utile. Une solution de secours doit être évaluée comme une autre charge de travail avec ses propres dépendances et conditions d'exactitude. Son nom ne prouve pas qu’il soit moins cher, plus sûr ou disponible à l’échelle du chemin principal défaillant.
Il existe également des tâches pour lesquelles des informations périmées sont inacceptables. Renvoyer un résultat informatif plus ancien avec un horodatage visible peut constituer une dégradation raisonnable pour certains lecteurs. Utiliser une ancienne décision d’autorisation ou présenter un état commercial obsolète comme étant actuel peut constituer un risque différent. L'application doit décider quelles parties du résultat peuvent se dégrader, comment cette condition est communiquée et quelles opérations doivent être refusées. Préserver la disponibilité en masquant l’incertitude peut nuire à l’entreprise, même si cela améliore l’apparence du tableau de bord du taux d’erreur. La réponse à un échec doit conserver un compte rendu véridique de ce que le service sait.
Le traitement de la surcharge par Google évoque les réponses dégradées et la nécessité de rejeter le travail lorsque même une réponse réduite ne peut pas être fournie. Cela fournit un contexte utile pour un choix de conception qui, autrement, pourrait paraître défaitiste : refuser certaines demandes peut protéger la capacité d’en compléter d’autres. Il ne choisit pas les priorités commerciales pour le service hypothétique. Ces priorités nécessitent un contrat explicite précisant quelles tâches peuvent attendre, lesquelles peuvent se dégrader et lesquelles devraient échouer rapidement. Le mécanisme technique doit alors faire respecter ce contrat plutôt que de simplement l'enregistrer dans un document. [5]
5. Le backoff modifie le timing ; jitter change de société
Deux clients peuvent avoir des retards individuellement sensibles et néanmoins arriver ensemble. Si une grande population échoue au même moment et que chaque membre attend le même intervalle, sa prochaine vague peut rester synchronisée. Un retard croissant modifie l'espacement entre les vagues sans nécessairement disperser les membres de chaque vague. Jitter introduit des variations dans leur timing. L’idée importante n’est pas le hasard comme ajout décoratif à une formule. Il s’agit d’éviter une population en rétablissement qui se présente à plusieurs reprises comme une explosion coordonnée. La répartition et les limites requises doivent correspondre au protocole, aux délais et à la charge de travail observée.
La discussion AWS sur l'intervalle exponentiel et la gigue illustre pourquoi le timing déterministe des nouvelles tentatives peut laisser des clusters de travail. Cela prend en charge le mécanisme de synchronisation, et non un choix de paramètre universel pour un autre service. Dans l'application hypothétique, un délai aléatoire plus long pourrait répartir les tentatives mais aussi en pousser certaines au-delà du délai utile de l'appelant. Une portée plus courte pourrait respecter le délai tout en faisant trop peu pour réduire la synchronisation. La conception nécessite les deux contraintes. Il ne doit pas considérer le nom d’un algorithme choisi comme une preuve que chaque délai généré est approprié pour la tâche. [6]
Une boucle de nouvelle tentative nécessite également une interprétation de la réponse. Un échec d'authentification, une règle métier rejetée et une limite de capacité temporaire ne demandent pas le même comportement. La répétition d'une demande invalide inchangée ne peut généralement pas réparer les informations qui l'ont rendue invalide. Une réponse de limitation peut fournir des indications temporelles, mais l'appelant doit toujours respecter son propre délai et son allocation globale. Un échec de connexion peut rendre l’exécution incertaine. La classification doit conduire à une décision concernant l'opération, et pas seulement à une recherche qui attribue à chaque exception un autre nombre de tentatives.
Le calendrier des tentatives doit inclure le temps passé à effectuer un travail utile, à attendre une réponse et à attendre avant une autre tentative. Une politique peut paraître courte lorsque ses retards sont répertoriés séparément, mais dépasser le temps total alloué à la tâche une fois l'exécution incluse. Il convient également de tenir compte des tentatives qui se chevauchent si l'application le permet. La spéculation parallèle peut parfois réduire la latence, mais elle nécessite pour ce faire des capacités supplémentaires. En cas de surcharge, ce compromis peut être particulièrement coûteux. Une organisation doit savoir quand le service fait ce choix, quelles opérations sont admissibles et ce qui met fin au travail supplémentaire.
Le planning n'est pas la seule source de synchronisation. Les interrogations périodiques, l'actualisation des jetons, les démarrages par lots programmés et le redémarrage d'une flotte de processus après un événement partagé peuvent tous concentrer l'activité. La panne hypothétique pourrait donc se reproduire même après l’amélioration de la boucle de nouvelle tentative explicite. L'enquête utile demande quelles horloges sont partagées au sein de la charge de travail et quelles actions coûteuses elles déclenchent. Répartir le travail en arrière-plan peut aider, mais les délais, les heures de bureau et les fenêtres de service externes peuvent restreindre cette liberté. Une solution correcte modifie le modèle d'arrivée pertinent tout en conservant l'objectif de la tâche planifiée.
L'appelant qui appuie à nouveau sur le bouton
Les gens peuvent être une autre couche de réessais. Un écran qui tourne sans expliquer si une demande a été acceptée invite à une nouvelle soumission. Un bouton désactivé peut réduire les doublons accidentels mais ne peut pas établir l'état du serveur après une réponse perdue. Une référence d'opération durable et une vue claire de l'état peuvent donner au lecteur un moyen d'inspecter la première demande au lieu d'en créer une autre. L'interface doit distinguer l'attente d'une opération acceptée de la demande au serveur de démarrer une nouvelle opération. Cette distinction devient particulièrement précieuse lorsqu’un court délai interactif se situe devant un processus asynchrone plus long.
La formulation est importante car le logiciel fait une promesse. Dire qu’une demande a échoué alors que son résultat est inconnu encourage une action différente de celle de dire que le traitement a été accepté et que son statut est en cours de vérification. Aucun des deux messages ne doit prétendre à une certitude que le système ne possède pas. La vue d'état doit également éviter de devenir une source d'interrogation incontrôlée lors de l'incident. Le choix de l'intervalle, la mise en cache de l'état le cas échéant et la limitation des actualisations répétées font partie de la même conception de capacité. Une expérience utilisateur utile aide les gens à retrouver leur intention sans transformer leur incertitude en une autre vague de travail.
6. Le trafic de récupération a besoin d’un chemin de retour
Un service piloté par file d'attente introduit une autre distinction : le traitement réussi et l'accusé de réception réussi sont des événements distincts. L'effet commercial peut être terminé avant que le courtier n'apprenne que le message peut être supprimé. Si l'accusé de réception est perdu, le système peut revoir le message. Azure Service Bus documente les transferts, les verrous et le règlement en tant que parties distinctes de la livraison. La conséquence architecturale est de relier l'identité de traitement du message à l'opération commerciale et de gérer délibérément les livraisons répétées. L’augmentation du seuil du nombre de livraisons ne garantit pas que les exécutions répétées sont sûres. [7]
Le travailleur doit également reconnaître un travail qui ne deviendra pas valable par la répétition. Une charge utile mal formée, une version d'opération non prise en charge ou un prérequis manquant de façon permanente peuvent nécessiter une correction ou une enquête. Le remettre indéfiniment dans la file d'attente active peut dépenser de la capacité sans améliorer les chances de succès. Un chemin de défaillance distinct peut maintenir la charge de travail ordinaire en mouvement, mais ce chemin a besoin d'un propriétaire et d'une conséquence visible. Une file d'attente de lettres mortes dont le contenu n'est jamais examiné ne constitue pas une stratégie de récupération ; il s’agit d’une accumulation de promesses non résolues qui se trouvent en dehors du tableau de débit principal.
La documentation sur les lettres mortes du Service Bus de Microsoft explique le rôle de la sous-file d'attente secondaire et la nécessité pour les applications de traiter ses messages. Le choix important pour le service hypothétique est ce qui se passe avant toute nouvelle soumission. L’équipe doit déterminer si le défaut sous-jacent a été corrigé, si l’intention commerciale initiale est toujours d’actualité et si une tentative antérieure a déjà produit un effet. Une rediffusion groupée qui ignore ces questions peut convertir une ancienne incertitude en une nouvelle charge. La procédure de récupération doit être capable de sélectionner le travail, plutôt que de traiter chaque message stocké comme étant également sûr à exécuter à nouveau. [8]
Lorsque la capacité revient, la demande réelle et les travaux de récupération historiques entrent en concurrence. Un service qui draine toutes les anciennes tâches au débit maximum disponible peut entraîner une deuxième panne pour les utilisateurs actuels. Un service qui réserve tout pour de nouveaux travaux risque de ne jamais rattraper son retard. Le taux de libération pour les travaux de récupération nécessite donc une politique liée à la capacité inutilisée réelle et à la priorité de l'entreprise. Il peut être ajusté à mesure que le comportement de la dépendance change. L'essentiel est que la récupération est une charge de travail à part entière et non une catégorie particulière exemptée des limites appliquées au trafic ordinaire.
La décision de récupération comporte également une condition d’arrêt. Une relecture peut devoir être interrompue lorsque la latence augmente, lorsque la requête active la plus ancienne dépasse son âge utile, lorsque la détection des doublons détecte un modèle inattendu ou lorsqu'une dépendance recommence à être limitée. Les signaux pertinents dépendent du service. Ce qui compte, c'est que la personne ou le mécanisme qui libère les anciens travaux puisse les observer et agir avant que le tampon ne devienne la source d'une nouvelle poussée. Une commande de relecture sans chemin de retour offre de la persistance, mais peu de contrôle sur ses conséquences.
Préserver la provenance rend ces commentaires plus utiles. Une opération doit être traçable depuis sa première soumission, ses tentatives ultérieures, ses livraisons en file d'attente et toute correction manuelle. Les identifiants n'ont pas besoin d'exposer du contenu sensible pour y parvenir. Ils ont besoin d'une relation stable avec l'intention commerciale et d'un contexte de configuration suffisant pour expliquer la politique sous laquelle chaque tentative s'est exécutée. Sans cette continuité, une équipe peut consacrer sa réponse aux incidents à décider si elle s'intéresse à une opération tenace, à de nombreuses nouvelles demandes ou à un mélange des deux. Le volume de journalisation supplémentaire devient alors une autre pression sur les ressources sans fournir la compréhension nécessaire.
7. Recherchez le travail qui est effectué
Un service peut être à la fois occupé, disponible et inutile. Le processeur, l'utilisation de la connexion et le taux de requêtes décrivent l'activité, tandis que les complétions utiles décrivent la progression. Aucune des deux catégories ne remplace l’autre. L’observation intéressante est la façon dont ils divergent. Si les tentatives augmentent alors que les opérations uniques terminées diminuent, le service peut dépenser plus pour obtenir moins. Si la latence s'améliore uniquement parce qu'une plus grande fraction du travail est rejetée, l'application peut avoir protégé ses ressources tout en faisant échouer de nombreux lecteurs. La vision opérationnelle devrait rendre les deux faits visibles plutôt que de choisir la mesure qui raconte l’histoire la plus rassurante.
Le dénominateur est particulièrement important pour une application qui effectue une nouvelle tentative. Un taux de réussite au niveau des tentatives peut être faussé par le nombre de tentatives par opération. Un taux d'achèvement au niveau de l'utilisateur peut masquer la quantité de ressources consommées nécessaire pour produire chaque succès. Un tableau de bord utile sépare la demande initiale, le nombre total de tentatives, le travail admis, les opérations uniques terminées, le délai d'achèvement utile et les résultats qui restent incertains. Il montre également l'âge et la classe de charge de travail pour lesquels ces distinctions affectent la décision. Ces mesures décrivent différentes questions ; les collecter n’est utile que lorsque l’équipe peut relier un changement en eux à une action.
Un rapport de diagnostic correspond aux tentatives d'appels de dépendance par opération d'origine. Une autre raison est la part du peu de temps d’exécution consacrée aux opérations dont le délai de lancement est déjà expiré. Ni l’un ni l’autre ne devrait être considéré comme un objectif de niveau de service universel. Ce sont des moyens de rendre visible un mécanisme suspecté. La définition doit être suffisamment précise pour éviter de considérer la récupération de connexion inoffensive comme une exécution commerciale supplémentaire ou de traiter une tâche intentionnellement asynchrone comme un travail abandonné. La mesure est utile lorsqu’elle fait la distinction entre les explications, et non lorsqu’elle fournit une autre ligne attrayante sur le tableau de bord des incidents.
Le coût fait partie de cette observation. Les tentatives supplémentaires peuvent augmenter les frais de requête, le volume de journalisation, le taux de désabonnement des connexions ou la consommation de calcul, même si elles n'effectuent pas davantage de travail professionnel. Un coût par requête peut sembler s'améliorer si le dénominateur augmente avec les tentatives, tandis que le coût par résultat utile se détériore. L'organisation a besoin d'une vision des coûts qui suit suffisamment la tâche pour inclure les efforts échoués et répétés. Aucune économie n’est réclamée ici. Le but est de choisir une limite comptable qui révélerait si un changement de résilience proposé réduit le gaspillage plutôt que de simplement le déplacer vers un autre service ou une autre facture.
Testez la chaîne, pas seulement la boucle
Une nouvelle tentative réussie dans un test unitaire n'établit que très peu de choses sur une flotte en échec corrélé. Un test contrôlé plus révélateur modifie la latence ou la capacité d'achèvement d'une dépendance tout en gardant la demande initiale identifiable. Il observe si la tentative d'amplification reste limitée, si les délais mettent fin au travail comme prévu et si le débit utile se rétablit après la perturbation. L'environnement et les limites devraient rendre ce test sûr. L’objectif n’est pas de provoquer un incident de production incontrôlé pour faire preuve de ténacité. Il s'agit de remettre en question l'hypothèse spécifique selon laquelle des tentatives supplémentaires restent utiles lorsque de nombreux appelants échouent ensemble.
Les scénarios doivent distinguer les réponses lentes, les rejets définitifs et les résultats inconnus. Ils doivent inclure une dépendance qui récupère avant la date limite de l'appelant et une autre qui ne le fait pas. Un service basé sur une file d'attente doit également exercer une incertitude d'accusé de réception, un travail expiré et une relecture délibérément contrainte. Le résultat attendu n’est pas simplement que chaque tâche soumise finisse par réussir. Certaines tâches doivent être refusées ou cesser d'être essayées. La question significative est de savoir si le résultat observé correspond au contrat, tandis que la ressource limitée reste protégée et que l'organisation peut expliquer ce qui est arrivé à chaque classe de travail.
Une comparaison nécessite la même exigence initiale. Sinon, une configuration qui semble récupérer plus rapidement peut simplement avoir reçu une charge de travail plus facile. Le compte doit conserver le modèle d'arrivée, la combinaison de tâches, la condition de dépendance et les versions de configuration pertinentes pour le résultat. Il doit distinguer les exemples calculés tels que le graphique de cet article des mesures obtenues lors d'un test en cours. Répéter une histoire numérique plausible comme s’il s’agissait d’une référence affaiblirait les preuves. Un petit modèle transparent est utile parce que ses hypothèses peuvent être remises en question, et non parce que ses lignes lisses ressemblent à une trace de production.
8. Le système qui est autorisé à arrêter d'essayer
Revenir à la première demande différée. Il n’était pas nécessaire que cela devienne une panne. La chaîne de défaillance a acquis sa force à travers plusieurs transitions : un timeout était interprété comme une autorisation de commencer davantage de travail ; les strates multiplient les tentatives sans budget commun ; le travail en attente masquait un déficit de capacité grandissant ; et le trafic de récupération était traité comme si son urgence créait un débit supplémentaire. Chaque transition offre un endroit pour interrompre la chaîne. La conception ne nécessite pas tous les modèles de résilience possibles. Des contrôles sont nécessaires aux points où ce service peut transformer l'incertitude en charge supplémentaire ou en effet commercial répété.
Il existe des circonstances dans lesquelles une nouvelle tentative constitue exactement la bonne réponse. Un bref échec indépendant peut disparaître, une lecture sécurisée peut se terminer rapidement sur un autre itinéraire, ou une nouvelle soumission limitée peut récupérer une tâche précieuse. L’argument n’est pas contre la persévérance. C'est de la persévérance qu'il faut rendre compte du temps, de la capacité et du sens de l'opération. Un service doit être capable d'expliquer pourquoi une tentative a été faite, quelle allocation l'a payée et quelle observation empêcherait la suivante. Cette explication est plus utile qu'une déclaration générique indiquant que les tentatives ont été activées pour des raisons de fiabilité.
La capacité de récupération la plus importante pourrait donc être la capacité de s’arrêter. Arrêtez de créer des tentatives lorsque le délai a rendu leur résultat inutile. Arrêtez d’emprunter de la capacité à des travaux non liés. Arrêtez de rejouer un retard lorsque le service en direct commence à souffrir. Arrêtez de prétendre à un échec définitif lorsque le résultat de l’exécution est encore inconnu. Ce sont des décisions différentes, et chacune nécessite un propriétaire ou un mécanisme approprié. Ensemble, ils permettent à la dépendance sous-jacente de se rétablir et à l'organisation de corriger le travail qui reste, au lieu de forcer chaque intention non résolue à suivre le même chemin surchargé.
Un service fiable ne promet pas d’essayer éternellement. Cela constitue une promesse plus pratique : un travail accepté a une signification définie, un effort supplémentaire a une limite et un échec produit un résultat que les gens peuvent comprendre et sur lequel agir. Lorsque ces conditions sont réunies, les nouvelles tentatives peuvent rester un outil utile plutôt que de devenir une charge de travail invisible sans client responsable. La différence apparaît plus clairement lors de la récupération. À mesure que le défaut initial disparaît, le système a suffisamment de contrôle sur son propre comportement pour permettre la reprise du travail utile.