Надёжность систем
Когда повторные попытки приводят к сбою
Небольшое замедление может обернуться сбоем всей системы, когда каждый уровень пытается восстановиться самостоятельно. Следуйте за цепочкой и границами, которые могут ее остановить.
Следуйте цепочке неудач
- 1. Небольшая задержка обретает вторую жизнь
- 2. Умножение происходит между командами.
- 3. Залы ожидания не создают вместимости
- 4. Установите границу, через которую перегрузка не сможет заимствовать
- 5. Отсрочка меняет время; Джиттер меняет компанию
- 6. Для восстановления трафика нужен маршрут домой
- 7. Следите за тем, что делается
- 8. Система, которой разрешено перестать пытаться
Одно намерение, двадцать семь возможных попыток
Открыть полноразмерное изображение ↗Объяснение и предположения
Наихудшее иллюстративное ветвление: три слоя, каждый из которых допускает всего три попытки, включая оригинал. Никакого раннего успеха или отмены; фактический трафик зависит от реализации. Площади кольца не являются показателем рабочей нагрузки.
Первый неудачный запрос зачастую является наименее интересной частью сбоя. Зависимость занимает больше времени, чем ожидалось, один из вызывающих абонентов прекращает ожидание, и приложение пытается снова. Это выглядит как разумное действие по восстановлению. Трудность возникает, когда тысячи других абонентов приходят к такому же выводу, несколько слоев предпринимают собственные попытки, а первоначальная работа все еще выполняется. Сейчас система тратит все большую долю своей мощности на восстановление после нагрузки, создаваемой ее механизмами восстановления. Ничто в отдельном цикле повторов не должно выглядеть явно необоснованным, чтобы комбинированное поведение стало разрушительным.
Рассмотрим явно гипотетическую службу статуса заказа. Обычно у него достаточно мощности для входящей работы, но нисходящая зависимость замедляется на две минуты. Запросы остаются в полете дольше, время ожидания вызывающего объекта начинает истекать, и клиентская библиотека начинает новую попытку. Внешняя служба также имеет политику повтора. Пользовательский интерфейс предлагает кнопку повторной попытки, поскольку собственный крайний срок истек. Спрос бизнеса почти не изменился, однако зависимость приводит к увеличению количества попыток выполнить работу именно тогда, когда она может выполнить меньше. Эта статья следует этой цепочке, а затем исследует места, где дизайн может ее прерывать. Сценарий и каждый числовой пример являются иллюстративными, а не описанием инцидента с клиентом MGCA или измеренным контрольным показателем.
Повторная попытка — это новый запрос ресурсов, даже если он представляет собой старое намерение. Это различие является отправной точкой для понимания неудачи. Предприятию по-прежнему может потребоваться одно обновление статуса, одна поданная заявка или один заполненный отчет. Инфраструктура может обрабатывать несколько попыток его создания. Если информационные панели подсчитывают запросы, не связывая их с базовой операцией, дополнительная активность может выглядеть как всплеск клиентского спроса. Если успех измеряется за попытку, а не за полезный результат, услуга также может оказаться более полезной, чем опыт человека, ожидающего ее.
1. Небольшая задержка обретает вторую жизнь
Тайм-аут отвечает на локальный вопрос: как долго этот абонент будет ждать? Сам по себе он не отвечает на вопрос, остановлена ли удаленная операция, произошел сбой до ее выполнения или она завершилась без получения подтверждения. Это разные результаты. При чтении повторение запроса может в основном потреблять ресурсы. При записи неопределенный результат также может создать проблему корректности. Возможно, принимающая система уже зафиксировала изменение. Желание звонящего получить однозначный ответ не делает безопасным другое исполнение. Поэтому защиту емкости и корректность бизнеса необходимо рассматривать вместе, а не назначать повторные попытки транспортному уровню и предполагать, что остальная часть приложения не будет затронута.
Первой реакцией на замедление часто является увеличение таймаута. Это может уменьшить количество ложных сбоев, когда нормальное отклонение было ошибочно принято за сбой. Это также может дольше удерживать больше запросов, занимающих ресурсы. Уменьшение тайм-аута создает противоположный компромисс: вызывающие абоненты быстрее выходят из состояния ожидания, но могут инициировать попытки замены, пока предыдущая работа остается активной. Ни одно из направлений не является по своей сути правильным. Полезный вопрос заключается в том, какие ресурсы остаются занятыми, какая работа фактически останавливается и как выбранный срок связан с ценностью выполнения задачи. Изменение номера без ответа на эти вопросы может скорее усилить давление, чем устранить его.
Существует также более одного часа. Установление соединения, разрешение имени, получение идентификационного токена, ожидание пулового соединения и получение ответа могут занимать часть доступного времени вызывающего абонента. Тайм-аут запроса, исключающий более раннее ожидание, может создать неверное впечатление об всей операции. И наоборот, независимо щедрые льготы на каждом этапе могут привести к общей задержке, намного превышающей обещания, данные пользователю. Проекту необходим последовательный учет прошедшего времени, включая время, проведенное до начала удаленного вызова и между попытками. Важной границей является вся задача, а не тот таймер, который проще всего настроить.
Представьте себе, что в гипотетическом сервисе видимая страница перестает ждать через пять секунд, в то время как внутреннему клиенту разрешено продолжать ждать двадцать. Эти значения не являются рекомендуемыми настройками. Они обнажают проблему собственности. Часть этого периода сервис может работать над запросом, исходный читатель которого уже ушел. Если страница отправляет новую операцию, старая работа и новая работа конкурируют. Если отмена распространяется, принимающий компонент все равно должен определить, что он может отменить безопасно. Остановка ожидания сети и отмена зафиксированной транзакции — это не одно и то же. Крайний срок может положить конец полезности результата, не обращая вспять его последствий.
Следовательно, первая точка прерывания — это срок, у которого есть владелец. Компонент должен знать, сколько оставшегося времени операции он может потратить, может ли в рамках нее завершиться еще одна попытка и что произойдет, когда это время истечет. Ответом может быть явный сбой, сохраненная асинхронная операция со ссылкой на состояние или результат, помеченный как незавершенный. Это не должен быть невидимый перенос той же работы в другой неограниченный цикл повторов. Политика восстановления полезна, когда она повышает вероятность получения допустимого результата в рамках фактических ограничений задачи.
В инженерном руководстве Amazon обсуждаются тайм-ауты, задержка, дрожание и риск того, что вызов с истекшим временем ожидания уже привел к побочным эффектам. Microsoft описывает связанный с этим антишаблон «повторный шторм»: частые попытки могут помешать восстановлению службы, испытывающей затруднения. Эти источники поддерживают общий механизм, а не подтверждают конкретные цифры в этой статье. Приведенные ниже рассуждения о проектировании применяют этот механизм к намеренно упрощенному сервису, чтобы последствия оставались проверяемыми. [1] [2]
2. Умножение происходит между командами.
Три попытки звучат скромно. Три уровня, каждый из которых допускает три попытки, могут быть совершенно разными. При конкретном предположении наихудшего случая, что каждая внешняя попытка вызывает все внутренние попытки и ни одна из них не завершается успехом раньше времени, самая глубокая зависимость может получить двадцать семь попыток для одной исходной операции. Это умножение по иерархии вызовов, а не утверждение, что каждый сбой автоматически приводит к такому подсчету. Отмена, сроки, ранний успех, состояние цепи и фактическое право собственности на повторную попытку могут уменьшить ее. Цель расчета — выявить взаимодействие, которое легко пропустить, если каждый компонент рассматривается независимо.
Здесь важна терминология. Параметр, описываемый как три повтора, может означать исходную попытку и еще три, тогда как три попытки включают исходную. Путаница в этих определениях меняет расчет еще до того, как в него войдут какие-либо детали реализации. При обсуждении архитектуры следует записать общее количество попыток, разрешенных на каждой границе, и определить, какой компонент их запускает. Оно также должно включать поведение, предоставляемое клиентскими библиотеками, шлюзами и инфраструктурой. Диаграмма, на которой показан только код приложения, может не включать механизм повтора, который доминирует в трафике. Компонент, который скрывает ошибку от вызывающего объекта, по-прежнему увеличивает рабочую нагрузку системы.
Организационная причина понятна. Каждая команда хочет, чтобы ее собственный сервис допускал кратковременные перерывы. Общая библиотека применяет стандартную политику. Шлюз добавляет еще один уровень защиты. Работник рассматривает исключение как причину отказаться от обработки и получить сообщение снова. Ни один из этих вариантов не должен быть небрежным. Неудача возникает потому, что политики имеют общую зависимость, но не имеют общего бюджета. Местная устойчивость превратилась в коллективный оптимизм: каждый участник предполагает, что еще одна попытка вполне доступна, в то время как ни один из участников не несет ответственности за общее количество попыток, которые может произвести бизнес-операция.
Радиальная диаграмма в проеме делает это видимым. Его кольца представляют одну исходную операцию, затем три, девять и двадцать семь возможных последующих попыток в намеренно ограниченной модели. Кольца не измеряют трафик, а их площади не являются оценками производительности. Это способ проверить предположение о ветвлениях, не рисуя еще один прямоугольный ландшафт приложения. Следуйте единственному намерению наружу и спросите, где создается новая работа. Если несколько уровней могут независимо расширять его, просмотр только максимального количества повторных попыток конечного клиента не позволит определить максимальную нагрузку, которую может создать весь маршрут.
Одним из практических решений является явное определение владельца повторной попытки на границе, где приложение имеет достаточный контекст для оценки операции. Это не означает, что каждая система должна централизовать всю логику устойчивости в одном месте. Транспорт может разумно восстановить разорванное соединение, пока приложение выполняет более длительную задачу. Требование состоит в том, чтобы их совместное поведение было понятным и ограниченным. Нижний уровень не должен автоматически перезапускать полное бизнес-действие после того, как верхний уровень считает, что лимит задачи исчерпан. Граница между повторным подключением, повторной отправкой и повторным выполнением должна быть видна как при проектировании, так и при наблюдении.
Бюджет повторных попыток добавляет второй лимит сверх максимального значения для каждого запроса. Приложение может ограничить совокупный объем дополнительной работы, которую оно выполняет во время сбоя. Единицу учета необходимо выбирать сознательно: запросы, одновременные попытки, затраченное время, взвешенную стоимость или их комбинацию. Дешевое чтение из кэша и дорогой отчет не обязательно являются взаимозаменяемыми токенами. Механизм также должен определять, что происходит, когда бюджет пуст. Простое перемещение отклоненных повторных попыток в частную очередь позволяет сохранить нагрузку, скрывая ее от исходного ограничителя. Полезный бюджет меняет поведение, которое достигает ограниченного ресурса.
Не существует универсального процента, который делает такой бюджет правильным. Доступная емкость восстановления, контракт зависимостей, значение задачи и поведение при сбоях различаются. Служба может зарезервировать узкий допуск на короткие временные ошибки, отказываясь при этом увеличивать дорогостоящую работу во время постоянного сбоя. Другой может отложить подходящие задачи отдельно управляемому фоновому процессу. Важно то, что политика остается значимой, когда система испытывает стресс, когда успехов мало и когда несколько вызывающих систем терпят неудачу одновременно. Бюджет, пополнение которого зависит от успеха, нуждается в явной интерпретации этого периода низкого успеха, а не в случайном локауте или неограниченном чрезвычайном вмешательстве.
Неудачная попытка — это не новая бизнес-инструкция
Для службы с возможностью записи идентификатор операции должен пережить попытку. Если клиент генерирует новый бизнес-идентификатор каждый раз, когда повторно отправляет одно и то же намерение, получатель может разумно рассматривать запросы как разные операции. Если он повторно использует идентификатор без проверки связанного содержимого, один и тот же ключ может быть прикреплен к существенно различным изменениям. Поэтому идемпотентный дизайн требует большего, чем просто поле с именем идентификатора запроса. Ему необходимы область действия, связь с предполагаемым действием, период хранения и определенный ответ, когда поступает повторяющийся идентификатор с несовместимым содержимым.
Запись результата имеет не меньшее значение. Если получатель может идентифицировать завершенную операцию, но не может восстановить ее результат, вызывающая сторона может оставаться в неопределенности, даже если дублирование выполнения предотвращено. Служба должна решить, может ли она вернуть предыдущий результат, предоставить ссылку на статус или потребовать расследования. Правильное расположение зависит от операции и требований к обработке информации. Общее различие стабильно: распознавание старой инструкции, предотвращение другого эффекта и объяснение существующего эффекта — это связанные возможности, но они не доставляются автоматически одним и тем же механизмом.
3. Залы ожидания не создают вместимости
Очередь может облегчить управление рабочей нагрузкой. Он отделяет принятие от исполнения и дает потребителям возможность обрабатывать работу с устойчивой скоростью. За этим также может скрываться растущее обещание, которое служба не может выполнить. Таким образом, глубина очереди не является ни показателем успеха, ни объяснением сама по себе. Очередь, содержащая десять медленных отчетов, может потребовать больше работы, чем очередь, содержащая тысячу небольших обновлений. Короткая очередь срочных запросов уже может быть слишком старой. Полезное наблюдение связывает отставание со стоимостью обслуживания, производительностью завершения и временем, по истечении которого результат теряет свою бизнес-ценность.
Шаблон выравнивания нагрузки на основе очередей Microsoft описывает использование буфера для сглаживания спроса и подчеркивает необходимость контроля последующей обработки. Картина меняется, когда службе предлагается работа; он не производит пропускную способность. Эта граница важна при применении ее к гипотетическому замедлению. Если потребитель просто опустошает очередь как можно быстрее при восстановлении емкости, он может воссоздать первоначальный всплеск. Если потребители автомасштабирования увеличивают нагрузку на зависимость, которая остается ограниченной, очередь переместила перегрузку, а не разрешила ее. Сумма, высвобождаемая из буфера, требует своего собственного рабочего лимита. [3]
Емкость может восстановиться, в то время как отставание продолжает расти
Открыть полноразмерное изображение ↗Объяснение и предположения
Производительность: 60 юнитов/с в течение 120 секунд, затем 100 юнитов/сек. Начальное отставание: ноль. Дополнительные попытки в случае чувствительности: 40 ед./с.
Посмотреть данные расчета ↗На диаграмме используется намеренно простая жидкостная модель. Первоначальная потребность составляет восемьдесят единиц работы в секунду. Производительность обработки падает до шестидесяти в течение первых ста двадцати секунд, затем возвращается к ста. Каждая единица имеет одинаковую предполагаемую стоимость. Начальное количество невыполненных работ равно нулю, хранилище не имеет ограничивающего эффекта в этом расчете, и ни одна работа не истекает или не выходит из строя навсегда. Эти предположения делают арифметику прозрачной. Они не описывают полное поведение реального брокера, базы данных, сети или приложения. Цель состоит в том, чтобы показать, как неизмененная бизнес-нагрузка может восстановиться, в то время как рабочая нагрузка с усиленными попытками продолжает отставать.
Без дополнительного трафика попыток, допущенного в эту смоделированную очередь, каждую секунду во время замедления накапливается двадцать единиц. Через две минуты отставание составляет две тысячи четыреста. Как только мощность вернется к ста, а новый спрос останется на уровне восьмидесяти, у службы будет двадцать единиц резервной вычислительной мощности в секунду. Таким образом, очистка отставания занимает еще две минуты. Очередь пуста через двести сорок секунд с момента начала. Восстановление не происходит при мгновенном восстановлении мощности: сервис сначала должен погасить работу, которую он принял, пока она была медленнее, чем ее прибытие.
Теперь добавьте предполагаемые сорок единиц попыток в секунду на протяжении отображаемого интервала. Это случай чувствительности, а не прогноз конкретного алгоритма повтора. Прибывших становится сто двадцать против шестидесяти во время замедления, так что к двухминутному моменту накапливается семь тысяч двести единиц. После того, как мощность вернётся к ста, количество прибывших по-прежнему превышает завершение на двадцать. За шесть минут отставание вместо того, чтобы иссякнуть, достигло двенадцати тысяч. Дополнительный спрос в этом сравнении считается постоянным, чтобы изолировать его эффект. Реальное количество повторных попыток меняется в зависимости от сроков, отсрочки, успешных завершений и средств управления, которые применяет приложение.
Обе трассировки рассчитываются по одному и тому же правилу: отставание не может быть отрицательным и изменяется в зависимости от принятой работы минус выполненная работа. Их разные результаты не доказывают, что каждая повторная попытка вредна. Хорошо выбранная попытка после короткого независимого сбоя может восстановить ценную задачу. Трассировки показывают, почему попытку необходимо оценивать с учетом доступной мощности. Когда ограниченная служба не может обработать дополнительную нагрузку, большая настойчивость может продлить период, в течение которого никто не получит своевременных результатов. Уменьшение дополнительного трафика может быть действием по восстановлению, даже если базовая зависимость все еще восстанавливается.
Важно различать предлагаемую и допустимую нагрузку. Ограничитель может видеть большое количество запросов, но разрешать попадание в рабочую очередь только некоторым. Отклоненные попытки по-прежнему что-то стоят на границе, поэтому путь доступа должен быть достаточно недорогим, чтобы действовать в условиях давления. Им не следует выполнять один и тот же дорогостоящий вызов зависимости только для того, чтобы решить, отклонить ли его. В то же время дешевый отказ – это не выполненная задача клиента. Служба должна отдельно наблюдать за спросом, допуском, отклонением и полезным завершением, чтобы кажущееся сокращение роста очереди не было ошибочно принято за успешное выполнение.
Возраст очереди добавляет недостающее измерение времени. Предположим, конкретный отчет полезен только перед совещанием по принятию решения. Обработка его после встречи может иметь мало смысла, даже если система в конечном итоге сообщит об успехе. Продолжение этой работы на неопределенный срок может задержать выполнение новых задач, которые все еще имеют значение. Однако истечение срока действия должно быть бизнес-решением с видимым результатом, а не молчаливым удалением работы для улучшения диаграммы. Вызывающий должен знать, был ли запрос принят к выполнению, отклонен, заменен или срок его действия истек. Стабильная очередь, достигнутая за счет отказа от ее контракта, не является восстановленной услугой.
Те же рассуждения усложняют определение приоритета. Предоставление приоритета срочным задачам может защитить важные результаты, но постоянный поток срочной работы может истощить все остальное. Справедливость между арендаторами, операциями и классами рабочей нагрузки требует четкой политики. Единая глобальная очередь «первым пришел — первым обслужен» может быть простой в использовании, но при этом обеспечивает плохую изоляцию. Множество небольших очередей могут улучшить разделение, одновременно увеличивая сложность мониторинга и планирования. Полезный выбор зависит от того, какие стороны разделяют скудные ресурсы и какие обещания организация может защитить, когда общий спрос не может быть удовлетворен немедленно.
4. Установите границу, через которую перегрузка не сможет заимствовать
Четыре разных лимита, одна услуга
Открыть полноразмерное изображение ↗Объяснение и предположения
Вход — Принять, отклонить или отложить дешево; сохранить идентичность операции. · Ожидание работы — Связанное хранение и полезный возраст; отдельный прямой эфир от повтора. · Активное исполнение — Ограничьте реальную работу с зависимостями, а не просто ожидание вызывающих абонентов. · Зависимость — Уважайте его возможности; выпускать восстановительные работы с контролируемой скоростью.
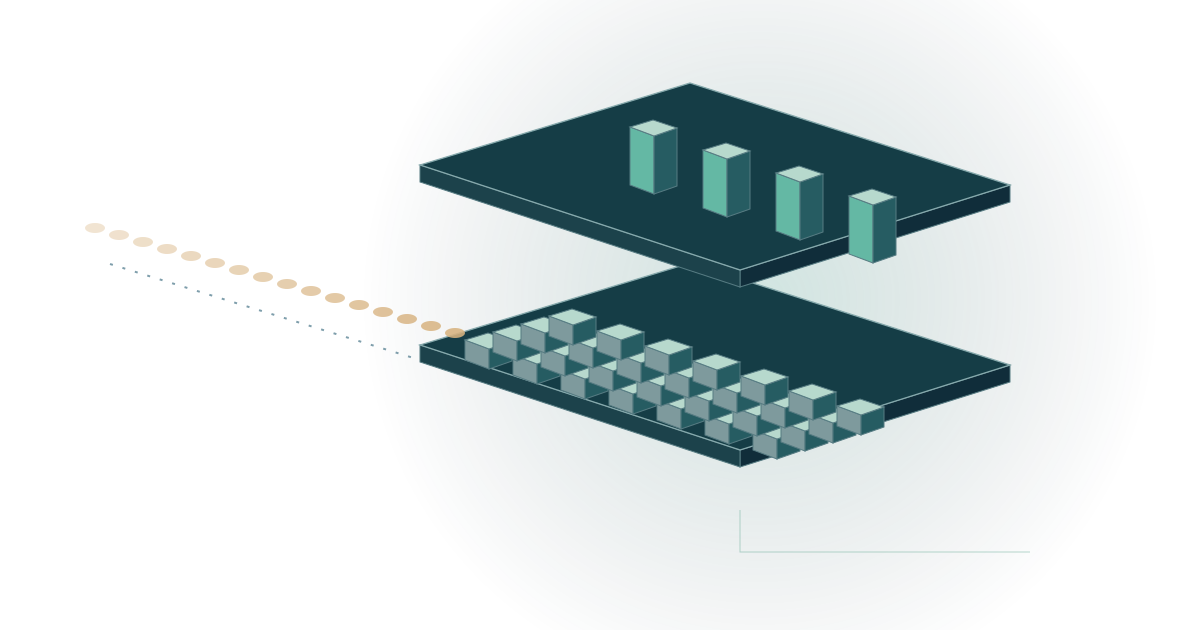
Изометрическое представление разделяет четыре задачи, которые часто сжимаются в одном сервисном блоке: прием, ожидание, активное выполнение и нисходящая зависимость. Каждый слой имеет свой дефицитный ресурс. Путь поступления должен принять быстрое решение. Буфер имеет ограниченный объем памяти и распределение по возрасту. Рабочие процессы потребляют память, слоты подключения и время выполнения. Зависимость имеет собственную емкость и границу разрешений. Отображение этих слоев помогает объяснить, почему увеличение количества рабочих не эквивалентно увеличению мощности всего сервиса. Ограничение на одном уровне можно обойти, если следующий уровень заимствует данные из неограниченного общего пула.
Возьмем работника, который ограничивает себя скромным количеством активных заданий, но позволяет каждому заданию открывать множество одновременных нисходящих вызовов. Ограничение верхнего уровня кажется ответственным, однако важный ресурс умножается под ним. Та же проблема возникает, когда тайм-аут освобождает разрешение уровня приложения до того, как базовая операция фактически прекратила использовать зависимость. Ограничитель считает одно, а ресурс платит за другое. В проекте должен быть указан момент получения разрешения, работа, которую оно охватывает, и наблюдения, оправдывающие его выдачу.
Изоляция полезна, поскольку несвязанная работа не должна терять всю свою производительность из-за самой медленной зависимости. Отдельные пулы или разрешения на параллелизм могут помешать неудачной интеграции занять ресурсы, необходимые здоровой. Это не бесплатно. Разделы могут оставить емкость незадействованной, пока другой раздел занят, а слишком большое количество разделов может затруднить настройку системы. Значение представляет собой более предсказуемую границу отказа. Выбор следует объяснять с точки зрения того, какие рабочие нагрузки могут влиять друг на друга, а не представлять переборки как универсальную инструкцию по созданию отдельной очереди и пула потоков для каждой функции.
Автоматический выключатель принимает решение, отличное от политики повторных попыток. Он может временно остановить попытки доступа к ресурсу, который с достаточной вероятностью выйдет из строя, и позволить контролируемым зондам оценить восстановление. Шаблон Microsoft описывает это разделение. Для гипотетического сервиса интересный вопрос заключается в том, что происходит вокруг прерывателя: расходуют ли заблокированные попытки бюджет повторных попыток, использует ли резервная работа ту же самую неудачную зависимость и остается ли совокупность зондов ограниченной во всех экземплярах. Прерыватель, изображенный на диаграмме архитектуры, сам по себе не устанавливает окружающее поведение. [4]
Откат может случайно усугубить ситуацию. Если промах в кэше отправляет каждый запрос к исходной зависимости, очевидно устойчивый путь к кэшу может концентрировать нагрузку в период низкой скорости попадания. Если у альтернативного провайдера более низкая квота, одновременное переключение всех вызывающих абонентов может перенести инцидент. Если вычисление ухудшенного ответа требует больших затрат, он может не сохранить достаточную емкость, чтобы быть полезным. Резервный вариант следует оценивать как другую рабочую нагрузку со своими зависимостями и условиями корректности. Его название не является доказательством того, что оно дешевле, безопаснее или доступно в масштабе вышедшего из строя основного пути.
Есть также задачи, для которых устаревшая информация неприемлема. Возврат более старого информационного результата с видимой меткой времени может быть разумным ухудшением качества для некоторых читателей. Использование старого решения об авторизации или представление устаревшего бизнес-состояния как текущего может представлять собой другой риск. Приложению необходимо решить, какие части результата могут ухудшиться, как об этом сообщается и от каких операций следует отказаться. Сохранение доступности за счет сокрытия неопределенности может нанести ущерб бизнесу, даже если это улучшит внешний вид информационной панели частоты ошибок. Реакция на сбой должна сохранять правдивую информацию о том, что известно службе.
В подходе Google к перегрузке обсуждаются ухудшенные ответы и необходимость отказываться от работы, когда даже сокращенный ответ не может быть выполнен. Это обеспечивает полезный контекст для выбора дизайна, который в противном случае может показаться пораженческим: отклонение некоторых запросов может защитить возможность выполнения других. Он не выбирает бизнес-приоритеты для гипотетической услуги. Эти приоритеты требуют четкого соглашения о том, какие задачи могут подождать, какие могут ухудшиться, а какие должны быстро выйти из строя. Затем техническому механизму необходимо обеспечить соблюдение этого контракта, а не просто зафиксировать его в документе. [5]
5. Отсрочка меняет время; Джиттер меняет компанию
Два клиента могут иметь индивидуально разумные задержки и при этом приходить вместе. Если большая популяция терпит неудачу в один и тот же момент и каждый ее член ждет один и тот же интервал, следующая волна может остаться синхронизированной. Растущая задержка меняет расстояние между волнами, не обязательно рассеивая участников каждой волны. Джиттер вносит изменения в их синхронизацию. Важная идея заключается не в том, что случайность является декоративным дополнением к формуле. Это значит избежать восстановления популяции, которая неоднократно представляет собой один скоординированный всплеск. Требуемое распределение и границы должны соответствовать протоколу, срокам и наблюдаемой рабочей нагрузке.
Обсуждение AWS экспоненциальной задержки и джиттера иллюстрирует, почему детерминированное время повтора может привести к потере кластеров работы. Это поддерживает механизм синхронизации, а не универсальный выбор параметров для другой службы. В гипотетическом приложении более длительная случайная задержка может распределить попытки, но также привести к тому, что некоторые из них превысят полезный крайний срок вызывающей стороны. Более короткий диапазон может соответствовать установленному сроку, но при этом сделать слишком мало для уменьшения синхронизации. При проектировании необходимы оба ограничения. Он не должен рассматривать выбранное имя алгоритма как доказательство того, что каждая сгенерированная задержка соответствует задаче. [6]
Цикл повтора также требует интерпретации ответа. Ошибка аутентификации, отклоненное бизнес-правило и временное ограничение мощности не требуют такого же поведения. Повторение неизмененного недействительного запроса обычно не может восстановить информацию, которая сделала его недействительным. Ответ на регулирование может предоставить рекомендации по времени, но вызывающему объекту все равно необходимо соблюдать собственный крайний срок и совокупное разрешение. Сбой соединения может привести к неопределенности выполнения. Классификация должна привести к решению об операции, а не просто к поиску, который присваивает каждому исключению другое количество попыток.
График попыток должен включать время, потраченное на полезную работу, ожидание ответа и ожидание перед следующей попыткой. Политика может выглядеть недостаточной, если ее задержки указаны отдельно, но при этом превышают все время выполнения задачи после включения в нее выполнения. Он также должен учитывать перекрывающиеся попытки, если приложение их допускает. Параллельная спекуляция иногда может уменьшить задержку, но для этого затрачиваются дополнительные мощности. При перегрузке этот компромисс может оказаться особенно дорогостоящим. Организация должна знать, когда служба делает этот выбор, какие операции подходят и что останавливает дополнительную работу.
Расписание — не единственный источник синхронизации. Периодический опрос, обновление токенов, запланированный пакетный запуск и перезапуск множества процессов после общего события — все это может сконцентрировать активность. Таким образом, гипотетический сбой может повториться даже после улучшения явного цикла повторов. В ходе полезного исследования выясняется, какие часы распределяются по всей рабочей нагрузке и какие дорогостоящие действия они запускают. Распределение фоновой работы может помочь, но сроки, рабочее время и окна внешних услуг могут ограничить эту свободу. Правильное решение меняет соответствующую схему прибытия, сохраняя при этом цель запланированной задачи.
Звонящий, который нажимает кнопку еще раз
Люди могут быть еще одним слоем повторных попыток. Экран, который вращается без объяснения того, был ли принят запрос, предлагает повторно отправить запрос. Отключенная кнопка может уменьшить количество случайных дубликатов, но не может определить состояние сервера после потери ответа. Надежная ссылка на операцию и четкое представление статуса могут дать читателю возможность проверить первый запрос вместо создания другого. Интерфейс должен отличать ожидание принятой операции от запроса к серверу начать новую операцию. Это различие становится особенно ценным, когда короткий интерактивный дедлайн ставится перед более длительным асинхронным процессом.
Формулировка имеет значение, потому что программное обеспечение обещает. Заявление о том, что запрос не выполнен, когда его результат неизвестен, побуждает к действию, отличному от заявления о том, что обработка принята и его статус проверяется. Ни одно сообщение не должно претендовать на уверенность, которой нет у системы. Просмотр статуса также не должен становиться неконтролируемым источником опроса во время инцидента. Выбор интервала, кэширование состояния, где это необходимо, и ограничение повторных обновлений являются частью одного и того же проектирования емкости. Полезный пользовательский опыт помогает людям восстановить свои намерения, не превращая свою неуверенность в очередную волну работы.
6. Для восстановления трафика нужен маршрут домой
Служба, управляемая очередями, вводит еще одно различие: успешная обработка и успешное подтверждение — это отдельные события. Бизнес-эффект может завершиться до того, как брокер узнает, что сообщение можно удалить. Если подтверждение потеряно, система сможет увидеть сообщение снова. Служебная шина Azure документирует передачу, блокировку и расчет как отдельные части доставки. Следствием архитектуры является объединение идентификатора обработки сообщения с бизнес-операцией и преднамеренная обработка повторной доставки. Увеличение порога количества доставок не означает, что повторное выполнение безопасно. [7]
Работнику также необходимо признать работу, которая не станет ценной из-за повторения. Неверный формат полезных данных, неподдерживаемая версия операции или постоянно отсутствующее предварительное условие могут потребовать исправления или исследования. Возврат его в активную очередь на неопределенный срок может привести к расходованию емкости без повышения шансов на успех. Отдельный путь отказа может поддерживать выполнение обычной рабочей нагрузки, но для этого пути нужен владелец и видимые последствия. Очередь недоставленных сообщений, содержимое которой никогда не проверяется, не является стратегией восстановления; это скопление невыполненных обещаний, которое оказывается за пределами основной диаграммы пропускной способности.
В документации по недоставленным сообщениям служебной шины Microsoft объясняется роль вторичной подочереди и необходимость того, чтобы приложения обрабатывали ее сообщения. Важным выбором для гипотетической службы является то, что происходит перед повторной отправкой. Команде необходимо установить, был ли исправлен основной дефект, актуально ли еще первоначальное бизнес-намерение и привела ли уже предыдущая попытка к результату. Массовое воспроизведение, пропускающее эти вопросы, может превратить старую неопределенность в новую нагрузку. Процедура восстановления должна иметь возможность выбирать работу, а не рассматривать каждое сохраненное сообщение как одинаково безопасное для повторного запуска. [8]
Когда мощность восстанавливается, реальный спрос и исторические работы по восстановлению конкурируют. Сервис, который сливает все старые задачи с максимально возможной скоростью, может привести к повторному отключению текущих пользователей. Служба, которая резервирует все для новой работы, может никогда не очистить отставание. Поэтому скорость высвобождения для восстановительных работ требует политики, привязанной к фактическим свободным мощностям и приоритетам бизнеса. Его можно корректировать по мере изменения поведения зависимости. Существенным моментом является то, что восстановление — это отдельная рабочая нагрузка, а не особая категория, освобожденная от ограничений, применяемых к обычному трафику.
Решение о восстановлении также имеет условие остановки. Воспроизведению может потребоваться приостановить, когда задержка увеличивается, когда самый старый действующий запрос превышает свой полезный возраст, когда обнаружение дубликатов обнаруживает неожиданный шаблон или когда зависимость снова начинает регулироваться. Соответствующие сигналы зависят от услуги. Важно то, что человек или механизм, выпускающий старую работу, может наблюдать за ней и действовать до того, как буфер станет источником нового всплеска. Команда воспроизведения без пути обратной связи обеспечивает постоянство, но мало контроля над ее последствиями.
Сохранение происхождения делает эту обратную связь более полезной. Операцию следует отслеживать на всех этапах ее первой отправки, последующих попыток, доставки в очередь и любых ручных исправлений. Для этого идентификаторам не обязательно раскрывать конфиденциальный контент. Им действительно нужна стабильная связь с бизнес-намерениями и достаточный контекст конфигурации, чтобы объяснить политику, в соответствии с которой выполнялась каждая попытка. Без такой преемственности команда может потратить время на реагирование на инциденты, решая, следует ли ей рассматривать одну упорную операцию, множество новых запросов или смесь того и другого. Дополнительный объем журналов становится еще одной нагрузкой на ресурсы, не обеспечивая необходимого понимания.
7. Следите за тем, что делается
Служба может быть занята, доступна и бесполезна одновременно. ЦП, использование соединения и частота запросов описывают активность, а полезные завершения описывают прогресс. Ни одна категория не заменяет другую. Интересное наблюдение заключается в том, как они расходятся. Если количество попыток растет, а число уникальных завершенных операций падает, возможно, служба тратит больше, чтобы достичь меньшего. Если задержка улучшится только потому, что большая часть работы будет отклонена, приложение, возможно, защитит свои ресурсы, но по-прежнему не сможет выполнить работу многих читателей. Оперативный взгляд должен сделать оба факта видимыми, а не выбирать тот показатель, который расскажет более обнадеживающую историю.
Знаменатель особенно важен для приложения, которое повторяет попытку. Уровень успеха на уровне попыток может быть искажен количеством попыток на операцию. Уровень завершения на уровне пользователя может скрыть количество потребления ресурсов, необходимое для достижения каждого успеха. Полезная информационная панель разделяет первоначальный спрос, общее количество попыток, разрешенную работу, уникальные завершенные операции, время до полезного завершения и результаты, которые остаются неопределенными. Он также показывает возраст и класс рабочей нагрузки, в которых эти различия влияют на решение. Эти меры описывают различные вопросы; их сбор полезен только тогда, когда команда может связать их изменение с действием.
Один диагностический коэффициент — это количество попыток вызова зависимостей на исходную операцию. Другим фактором является доля дефицитного времени выполнения, затраченного на операции, срок начала которых уже истек. Ни то, ни другое не следует рассматривать как цель универсального уровня обслуживания. Это способы сделать подозреваемый механизм видимым. Определение должно быть достаточно точным, чтобы безобидное восстановление соединения не считалось дополнительным бизнес-выполнением или не рассматривалось намеренно асинхронная задача как заброшенная работа. Эта мера ценна, когда она различает объяснения, а не тогда, когда она обеспечивает еще одну привлекательную линию на панели инцидентов.
Стоимость является частью этого наблюдения. Дополнительные попытки могут увеличить стоимость запросов, объем журналов, отток подключений или потребление вычислительных ресурсов, даже если они не выполняют больше бизнес-задачи. Затраты на каждый запрос могут улучшиться, если знаменатель растет с увеличением повторных попыток, в то время как стоимость полезного результата ухудшается. Организации необходимо представление о затратах, которое достаточно далеко следует за задачей и включает в себя неудачные и повторяющиеся усилия. Никакой экономии здесь не предполагается. Цель состоит в том, чтобы выбрать границу учета, которая бы показала, сокращает ли предлагаемое изменение устойчивости потери, а не просто переносит его на другую услугу или счет.
Проверьте цепь, а не только петлю
Успешная повторная попытка модульного теста очень мало что дает о парке, подвергшемся коррелированному сбою. Более показательный контролируемый тест изменяет задержку зависимости или производительность выполнения, сохраняя при этом идентифицируемую первоначальную потребность. Он наблюдает, остается ли ограниченным расширение попыток, завершаются ли работы в установленные сроки и восстанавливается ли полезная пропускная способность после нарушения. Окружающая среда и ограничения должны сделать этот тест безопасным. Цель состоит не в том, чтобы вызвать неконтролируемый производственный инцидент, чтобы продемонстрировать стойкость. Это значит бросить вызов конкретному предположению, что дополнительные попытки остаются полезными, когда многие вызывающие одновременно терпят неудачу.
В сценариях следует различать медленные реакции, явные отклонения и неизвестные результаты. Они должны включать зависимость, которая восстанавливается до истечения крайнего срока вызывающего объекта, и зависимость, которая не восстанавливается. Служба на основе очередей также должна учитывать неопределенность подтверждения, просроченную работу и намеренно ограниченное воспроизведение. Ожидаемый результат заключается не просто в том, что каждая поставленная задача в конечном итоге будет успешной. Некоторые задачи следует отклонить или прекратить попытки. Важный вопрос заключается в том, соответствует ли наблюдаемый результат контракту, в то время как ограниченный ресурс остается защищенным, и организация может объяснить, что произошло с каждым классом работ.
Для сравнения необходим тот же первоначальный спрос. В противном случае конфигурация, которая восстанавливается быстрее, возможно, просто получила более легкую рабочую нагрузку. Учетная запись должна сохранять шаблон прибытия, набор задач, условие зависимости и версии конфигурации, соответствующие результату. Следует отличать расчетные примеры, такие как диаграмма в этой статье, от измерений, полученных в ходе бегового теста. Повторение правдоподобной числовой истории, как если бы она была эталоном, ослабило бы доказательства. Прозрачная маленькая модель полезна потому, что ее предположения можно оспорить, а не потому, что ее плавные линии напоминают производственный след.
8. Система, которой разрешено перестать пытаться
Вернитесь к первому отложенному запросу. Это не должно было привести к отключению электроэнергии. Цепочка неудач приобретала свою силу через несколько переходов: тайм-аут интерпретировался как разрешение начать дополнительную работу; слои умножали попытки без общего бюджета; отложенная работа скрывала растущий дефицит мощностей; а восстановительный трафик рассматривался так, как будто его срочность создавала дополнительную пропускную способность. Каждый переход предлагает место для прерывания цепочки. Проект не требует использования всех возможных шаблонов устойчивости. Требуется контроль в тех точках, где эта услуга может превратить неопределенность в дополнительную нагрузку или повторяющийся бизнес-эффект.
Бывают обстоятельства, при которых еще одна попытка является совершенно правильным ответом. Кратковременный независимый сбой может исчезнуть, безопасное чтение может быстро завершиться по другому маршруту, а ограниченная повторная отправка может восстановить ценную задачу. Аргумент не против настойчивости. Именно настойчивость остается ответственной перед временем, возможностями и смыслом операции. Служба должна быть в состоянии объяснить, почему была предпринята попытка, какое пособие за нее заплатило и какое наблюдение помешало бы следующей. Это объяснение более полезно, чем общее утверждение о том, что повторные попытки разрешены для надежности.
Поэтому наиболее важной способностью к восстановлению может быть способность остановиться. Перестаньте предпринимать попытки, когда срок сделал их результат бесполезным. Перестаньте заимствовать способности у несвязанной работы. Прекратите воспроизведение невыполненной работы, когда работа живого сервиса начнет страдать. Перестаньте заявлять о явном провале, когда результат выполнения еще неизвестен. Это разные решения, и каждому нужен соответствующий владелец или механизм. Вместе они освобождают место для восстановления базовой зависимости и для организации исправления оставшейся работы, вместо того, чтобы заставлять каждое неразрешенное намерение возвращаться по тому же перегруженному пути.
Надежный сервис не обещает работать вечно. Это дает более практичное обещание: принятая работа имеет определенное значение, дополнительные усилия имеют предел, а неудача приводит к результату, который люди могут понять и принять в соответствии с ним. При соблюдении этих условий повторные попытки могут оставаться полезным инструментом, а не превращаться в невидимую рабочую нагрузку без ответственного клиента. Разница проявляется наиболее четко во время выздоровления. По мере устранения исходной неисправности система получает достаточный контроль над своим поведением, чтобы возобновить полезную работу.