Ingeniería de fiabilidad
Cuando los reintentos se convierten en la interrupción
Una pequeña desaceleración puede convertirse en una falla en todo el sistema cuando cada capa intenta recuperarse por sí sola. Siga la cadena y los límites que pueden detenerla.
Sigue la cadena del fracaso
- 1. Un pequeño retraso adquiere una segunda vida
- 2. La multiplicación ocurre entre equipos.
- 3. Las salas de espera no crean capacidad
- 4. Construya un límite que la sobrecarga no pueda atravesar
- 5. El retroceso cambia el tiempo; jitter cambia de empresa
- 6. El tráfico de recuperación necesita una ruta a casa
- 7. Busque el trabajo que se está haciendo
- 8. El sistema al que se le permite dejar de intentarlo
Una intención, veintisiete intentos posibles
Abrir imagen en tamaño completo ↗Explicación y suposiciones
Ramificación ilustrativa en el peor de los casos: tres capas, cada una de las cuales permite tres intentos en total, incluido el original. Sin éxito ni cancelación anticipada; El tráfico real depende de la implementación. Las áreas del ring no son una medida de la carga de trabajo.
La primera solicitud fallida suele ser la parte menos interesante de una interrupción. Una dependencia tarda más de lo esperado, una persona que llama deja de esperar y la aplicación vuelve a intentarlo. Parece una acción de recuperación sensata. La dificultad aparece cuando miles de personas que llaman llegan a la misma conclusión, varias capas hacen sus propios intentos y el trabajo original sigue ejecutándose. El sistema ahora está gastando una parte cada vez mayor de su capacidad en recuperarse de la carga creada por sus mecanismos de recuperación. Nada en un ciclo de reintento individual debe parecer obviamente irrazonable para que el comportamiento combinado se vuelva destructivo.
Considere un servicio de estado de pedido explícitamente hipotético. Normalmente tiene capacidad suficiente para el trabajo entrante, pero una dependencia descendente se ralentiza durante dos minutos. Las solicitudes permanecen en tránsito por más tiempo, el tiempo de espera de la persona que llama comienza a expirar y una biblioteca cliente comienza otro intento. Un servicio externo también tiene una política de reintento. Una interfaz de usuario ofrece un botón de reintento porque ya pasó su propia fecha límite. La demanda empresarial apenas ha cambiado, pero la dependencia ve más intentos de trabajo precisamente cuando puede completar menos. Este artículo sigue esa cadena y luego examina los lugares donde un diseño puede interrumpirla. El escenario y cada ejemplo numérico son ilustrativos, no son un relato de un incidente de un cliente de MGCA ni un punto de referencia medido.
Un reintento es una nueva solicitud de recursos, incluso cuando representa una intención anterior. Esa distinción es el punto de partida para comprender el fracaso. Es posible que la empresa aún desee una actualización de estado, una solicitud enviada o un informe completo. La infraestructura puede estar procesando varios intentos para producirlo. Si los paneles cuentan las solicitudes sin conectarlas con la operación subyacente, la actividad adicional puede parecer un aumento en la demanda de los clientes. Si el éxito se mide por intento y no por resultado útil, el servicio también puede parecer más saludable que la experiencia de la persona que lo espera.
1. Un pequeño retraso adquiere una segunda vida
Un tiempo de espera responde a una pregunta local: ¿cuánto tiempo esperará la persona que llama? Por sí solo, no responde si la operación remota se detuvo, falló antes de la ejecución o se completó sin entregar su acuse de recibo. Esos son resultados diferentes. Para una lectura, repetir la solicitud puede consumir principalmente recursos. En el caso de una escritura, un resultado incierto también puede crear un problema de corrección. Es posible que el sistema receptor ya haya confirmado el cambio. El deseo de la persona que llama de recibir una respuesta definitiva no hace que otra ejecución sea segura. Por lo tanto, la protección de la capacidad y la corrección empresarial deben considerarse juntas, en lugar de asignar reintentos a una capa de transporte y asumir que el resto de la aplicación no se ve afectada.
La primera respuesta a una desaceleración suele ser aumentar el tiempo de espera. Esto puede reducir las fallas falsas en las que la variación normal se confunde con una interrupción. También puede mantener más solicitudes ocupando recursos durante más tiempo. Reducir el tiempo de espera crea la compensación contraria: las personas que llaman liberan su estado de espera antes, pero pueden iniciar intentos de reemplazo mientras el trabajo anterior permanece activo. Ninguna dirección es inherentemente correcta. La pregunta útil es qué recursos siguen ocupados, qué trabajo se detiene realmente y cómo se relaciona el plazo elegido con el valor de completar la tarea. Cambiar un número sin responder esas preguntas puede mover la presión en lugar de eliminarla.
También hay más de un reloj. Establecer una conexión, resolver un nombre, obtener un token de identidad, esperar una conexión agrupada y recibir la respuesta pueden consumir parte del tiempo disponible de la persona que llama. Un tiempo de espera de solicitud que excluye una espera anterior puede dar una impresión engañosa de la operación total. Por el contrario, las asignaciones generosas de forma independiente en cada etapa pueden producir un retraso general mucho más allá de la promesa de cara al usuario. Un diseño necesita una cuenta coherente del tiempo transcurrido, incluido el tiempo transcurrido antes de que comience la llamada remota y entre intentos. El límite importante es toda la tarea, no el temporizador que resulte más fácil de configurar.
En el servicio hipotético, imagine que la página visible deja de esperar después de cinco segundos, mientras que a un cliente interno se le permite continuar durante veinte. Esos valores no son configuraciones recomendadas. Exponen un problema de propiedad. Durante parte de ese período, el servicio puede estar trabajando en una solicitud cuyo lector original ya se fue. Si la página envía una operación nueva, el trabajo antiguo y el nuevo compiten. Si la cancelación se propaga, el componente receptor aún necesita definir qué puede cancelar de forma segura. Detener una espera de red y deshacer una transacción comprometida no son la misma capacidad. Un plazo puede poner fin a la utilidad de un resultado sin revertir sus efectos.
El primer punto de interrupción es, por tanto, un plazo que tiene dueño. Un componente debe saber cuánto tiempo restante de la operación puede dedicar, si es plausible que otro intento termine dentro de ella y qué sucede cuando se agota ese tiempo. La respuesta puede ser un error claro, una operación asincrónica retenida con una referencia de estado o un resultado marcado como incompleto. No debería ser una transferencia invisible del mismo trabajo a otro bucle de reintento ilimitado. Una política de recuperación es útil cuando mejora las posibilidades de un resultado válido dentro de las limitaciones reales de la tarea.
La guía de ingeniería de Amazon analiza los tiempos de espera, los retrocesos, la inquietud y el riesgo de que una llamada con tiempo de espera ya haya producido efectos secundarios. Microsoft describe el antipatrón de reintento relacionado: los intentos frecuentes pueden impedir que un servicio en problemas se recupere. Estas fuentes respaldan el mecanismo amplio, en lugar de validar las cifras particulares de este artículo. El razonamiento de diseño que sigue aplica ese mecanismo a un servicio deliberadamente simplificado para que las consecuencias sigan siendo inspeccionables. [1] [2]
2. La multiplicación ocurre entre equipos.
Tres intentos parecen modestos. Tres capas, cada una de las cuales permite tres intentos en total, pueden ser bastante diferentes. Bajo el supuesto específico del peor de los casos, de que cada intento externo causa todos los intentos internos y ninguno tiene éxito temprano, la dependencia más profunda puede recibir veintisiete intentos para una operación original. Esto es una multiplicación en la jerarquía de llamadas, no una afirmación de que cada falla produce automáticamente ese recuento. La cancelación, los plazos, el éxito temprano, el estado del circuito y la propiedad real del reintento pueden reducirlo. El objetivo del cálculo es exponer una interacción que es fácil pasar por alto cuando cada componente se revisa de forma independiente.
La terminología importa aquí. Una configuración descrita como tres reintentos puede significar un intento original más tres más, mientras que tres intentos incluye el original. Confundir esas definiciones cambia el cálculo antes de que entre cualquier detalle de implementación. Una discusión sobre arquitectura debe anotar el total de intentos permitidos en cada límite e identificar qué componente los inicia. También debe incluir el comportamiento proporcionado por las bibliotecas, puertas de enlace e infraestructura del cliente. Un diagrama que muestra sólo el código de la aplicación puede omitir el mecanismo de reintento que domina el tráfico. El componente que oculta una falla a quien llama aún contribuye a la carga de trabajo del sistema.
La causa organizativa es comprensible. Cada equipo quiere que su propio servicio tolere una breve interrupción. Una biblioteca compartida adopta una política estándar. Una puerta de enlace agrega otra capa de protección. Un trabajador trata una excepción como un motivo para abandonar y recibir el mensaje nuevamente. Ninguna de estas opciones tiene por qué ser descuidada. El fracaso surge porque las políticas comparten una dependencia sin compartir un presupuesto. La resiliencia local se ha convertido en optimismo colectivo: cada participante asume que otro intento es asequible, mientras que ningún participante es responsable del número total de intentos que la operación empresarial puede generar.
El diagrama radial en la abertura lo hace visible. Sus anillos representan una operación original, luego tres, nueve y veintisiete posibles intentos posteriores en un modelo deliberadamente restringido. Los anillos no son tráfico medido y sus áreas no son estimaciones de desempeño. Son una forma de inspeccionar el supuesto de ramificación sin dibujar otro panorama de aplicaciones rectangular. Siga una única intención hacia afuera y pregunte dónde se crea el nuevo trabajo. Si varias capas pueden expandirlo de forma independiente, revisar solo los reintentos máximos del cliente final no establecerá la carga máxima que puede imponer toda la ruta.
Una respuesta práctica es hacer explícita la propiedad del reintento en el límite donde la aplicación tiene suficiente contexto para juzgar la operación. Eso no significa que todos los sistemas deban centralizar toda la lógica de resiliencia en un solo lugar. Un transporte puede recuperar razonablemente una conexión interrumpida mientras una aplicación gestiona una tarea más larga. El requisito es que su comportamiento combinado sea comprendido y delimitado. Una capa inferior no debe reiniciar silenciosamente una acción comercial completa después de que la capa superior crea que ha agotado la asignación de la tarea. El límite entre reconexión, reenvío y reejecución debe ser visible tanto en el diseño como en la observación.
Un presupuesto de reintento agrega un segundo límite más allá del máximo por solicitud. La aplicación puede limitar la cantidad total de trabajo adicional que introduce durante la falla. La unidad de contabilización debe elegirse deliberadamente: solicitudes, intentos concurrentes, tiempo transcurrido, un costo ponderado o una combinación. Una lectura en caché barata y un informe caro no son necesariamente tokens intercambiables. El mecanismo también debería definir qué sucede cuando el presupuesto está vacío. Simplemente mover los reintentos rechazados a una cola privada conserva la presión y la oculta del limitador original. Un presupuesto útil cambia el comportamiento que llega al recurso restringido.
No existe un porcentaje universal que haga que ese presupuesto sea correcto. La capacidad de recuperación disponible, el contrato de dependencia, el valor de la tarea y el comportamiento de falla difieren. Un servicio podría reservar una asignación limitada para errores transitorios breves y al mismo tiempo negarse a multiplicar el trabajo costoso durante una falla persistente. Otro podría diferir las tareas elegibles a un proceso en segundo plano controlado por separado. Lo que importa es que la política siga siendo significativa cuando el sistema esté bajo presión, cuando los éxitos sean escasos y cuando varios interlocutores fracasen juntos. Un presupuesto cuya reposición depende del éxito necesita una interpretación explícita de ese período de escaso éxito, en lugar de un bloqueo accidental o una anulación de emergencia ilimitada.
Un intento fallido no es una nueva instrucción comercial
Para un servicio con capacidad de escritura, la identidad de la operación debe sobrevivir al intento. Si un cliente genera un nuevo identificador comercial cada vez que reenvía la misma intención, un receptor puede razonablemente tratar las solicitudes como operaciones diferentes. Si reutiliza un identificador sin verificar el contenido asociado, la misma clave podría adjuntarse a cambios materialmente diferentes. Por lo tanto, un diseño de idempotencia necesita más que un campo llamado ID de solicitud. Necesita un alcance, una relación con la acción prevista, un período de retención y una respuesta definida cuando llega un identificador repetido con contenido incompatible.
El registro de resultados es igualmente importante. Si el receptor puede identificar una operación completa pero no puede recuperar su resultado, la persona que llama puede permanecer insegura incluso aunque se evite la ejecución duplicada. El servicio debe decidir si puede devolver el resultado anterior, proporcionar una referencia de estado o requerir una investigación. La disposición correcta depende de la operación y de sus requisitos de manejo de información. La distinción general es estable: reconocer una instrucción antigua, prevenir otro efecto y explicar el efecto existente son capacidades relacionadas, pero no se entregan automáticamente mediante el mismo mecanismo.
3. Las salas de espera no crean capacidad
Una cola puede hacer que una carga de trabajo sea más fácil de controlar. Separa la aceptación de la ejecución y brinda a los consumidores la oportunidad de procesar el trabajo a un ritmo sostenible. También puede ocultar una promesa creciente que el servicio no puede cumplir. Por lo tanto, la profundidad de la cola no es una métrica de éxito ni una explicación por sí sola. Una cola que contiene diez informes lentos puede representar más trabajo que una que contiene mil actualizaciones pequeñas. Una cola corta de solicitudes urgentes puede que ya sea demasiado antigua. Esta útil observación conecta el trabajo atrasado con el costo del servicio, la capacidad de finalización y el tiempo más allá del cual el resultado pierde su valor comercial.
El patrón de nivelación de carga basado en colas de Microsoft describe el uso de un búfer para suavizar la demanda y destaca la necesidad de controlar el procesamiento posterior. El patrón cambia cuando se ofrece trabajo al servicio; no fabrica rendimiento. Ese límite es importante al aplicarlo a la hipotética desaceleración. Si el consumidor simplemente agota la cola lo más rápido posible cada vez que regresa la capacidad, puede recrear el aumento original. Si los consumidores de escalado automático aumentan la presión sobre una dependencia que permanece restringida, la cola ha movido la sobrecarga en lugar de resolverla. La cantidad liberada del colchón necesita su propio límite operativo. [3]
La capacidad puede recuperarse mientras el trabajo pendiente sigue creciendo
Abrir imagen en tamaño completo ↗Explicación y suposiciones
Capacidad: 60 unidades/s durante 120 segundos, luego 100 unidades/s. Atraso inicial: cero. Intentos adicionales en el caso de sensibilidad: 40 unidades/s.
Ver los datos del cálculo ↗El gráfico utiliza un modelo de fluido intencionalmente simple. La demanda original es de ochenta unidades de trabajo por segundo. La capacidad de procesamiento cae a sesenta durante los primeros ciento veinte segundos y luego vuelve a cien. Cada unidad tiene el mismo costo supuesto. El trabajo pendiente inicial es cero, el almacenamiento no tiene ningún efecto limitante en este cálculo y ningún trabajo caduca o falla permanentemente. Estos supuestos hacen que la aritmética sea transparente. No describen el comportamiento completo de un corredor, base de datos, red o aplicación real. El propósito es mostrar cómo una carga de trabajo empresarial sin cambios puede recuperarse mientras una carga de trabajo de intento amplificado continúa quedándose atrás.
Sin tráfico de intento adicional admitido en esta cola modelada, se acumulan veinte unidades por segundo durante la desaceleración. Después de dos minutos el retraso es de dos mil cuatrocientos. Una vez que la capacidad vuelve a cien y la nueva demanda sigue siendo de ochenta, el servicio tiene veinte unidades de capacidad de procesamiento adicional por segundo. Por lo tanto, eliminar el trabajo atrasado lleva otros dos minutos. La cola está vacía a doscientos cuarenta segundos del inicio. La recuperación no ocurre en el instante en que regresa la capacidad: el servicio primero tiene que reembolsar el trabajo que aceptó cuando era más lento que sus llegadas.
Ahora agregue unas cuarenta unidades de intento por segundo durante el intervalo mostrado. Este es un caso de sensibilidad, no una predicción de un algoritmo de reintento en particular. Las llegadas se convierten en ciento veinte contra sesenta durante la desaceleración, por lo que se acumulan siete mil doscientas unidades hacia los dos minutos. Después de que la capacidad vuelve a cien, las llegadas aún superan en veinte las terminaciones. A los seis minutos el retraso ha llegado a doce mil en lugar de agotarse. La demanda adicional en esta comparación se mantiene constante para aislar su efecto. Una población de reintentos real cambia con fechas límite, retrasos, finalizaciones exitosas y los controles que aplica la aplicación.
Los dos rastros se calculan a partir de la misma regla: el trabajo pendiente no puede ser negativo y cambia con el trabajo admitido menos el trabajo completado. Sus diferentes resultados no prueban que cada reintento sea perjudicial. Un intento bien elegido después de un breve fracaso independiente puede recuperar una tarea valiosa. Los seguimientos muestran por qué es necesario evaluar un intento con respecto a la capacidad disponible. Cuando el servicio restringido no puede procesar la carga adicional, una mayor persistencia puede alargar el período en el que nadie recibe un resultado oportuno. Reducir el tráfico adicional puede ser una acción de recuperación incluso mientras la dependencia subyacente aún se está reparando.
La distinción entre carga ofrecida y admitida es fundamental. Un limitador puede ver una gran cantidad de solicitudes pero permitir que solo algunas ingresen a la cola de trabajos. Los intentos rechazados todavía cuestan algo en el límite, por lo que la vía de admisión debe ser lo suficientemente económica como para operar bajo presión. No deberían realizar la misma costosa llamada de dependencia simplemente para decidir si la rechazan. Al mismo tiempo, un rechazo barato no es una tarea completada por el cliente. El servicio debe observar la demanda, las admisiones, los rechazos y las terminaciones útiles por separado para que una reducción aparente en el crecimiento de la cola no se confunda con un cumplimiento exitoso.
La antigüedad de la cola agrega la dimensión de tiempo que falta. Supongamos que un informe en particular es útil sólo antes de una reunión de decisión. Procesarlo después de la reunión puede tener poco valor, incluso si el sistema finalmente informa que fue exitoso. Mantener ese trabajo indefinidamente puede retrasar tareas más nuevas que aún importan. Sin embargo, la caducidad debe ser una decisión empresarial con un resultado visible, en lugar de eliminar silenciosamente el trabajo para mejorar un gráfico. La persona que llama necesita saber si la solicitud fue aceptada para su finalización, rechazada, reemplazada o permitida que caduque. Una cola estable lograda abandonando su contrato no es un servicio recuperado.
El mismo razonamiento complica la prioridad. Dar prioridad a las tareas urgentes puede proteger resultados importantes, pero un flujo permanente de trabajo urgente puede privar a todo lo demás. La equidad entre inquilinos, operaciones y clases de carga de trabajo necesita una política explícita. Una única cola global de primero en entrar, primero en salir puede ser fácil de operar y, al mismo tiempo, proporcionar un aislamiento deficiente. Muchas colas pequeñas pueden mejorar la separación y al mismo tiempo aumentar la complejidad del seguimiento y la programación. La elección útil depende de qué partes comparten un recurso escaso y qué promesas puede defender la organización cuando la demanda total no puede satisfacerse de inmediato.
4. Construya un límite que la sobrecarga no pueda atravesar
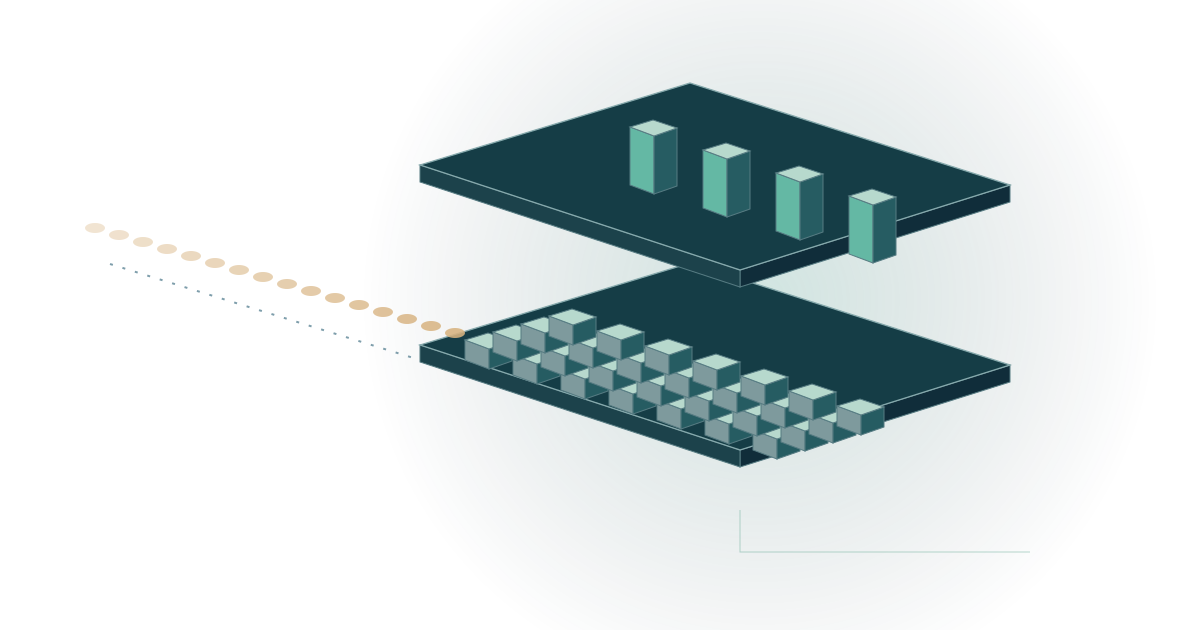
Cuatro límites diferentes, un servicio
Abrir imagen en tamaño completo ↗Explicación y suposiciones
Admisión — Aceptar, rechazar o aplazar a bajo precio; preservar la identidad de la operación. · esperando trabajo — Almacenamiento encuadernado y edad útil; separe la demanda en vivo de la repetición. · Ejecución activa — Limite el trabajo de dependencia real durante el vuelo, no solo las personas que llaman en espera. · dependencia — Respetar su capacidad; liberar el trabajo de recuperación a un ritmo controlado.
La vista isométrica separa cuatro preocupaciones que a menudo se comprimen en un solo cuadro de servicio: admisión, espera, ejecución activa y dependencia posterior. Cada capa tiene un recurso escaso diferente. El camino de admisión debe tomar una decisión rápida. El buffer tiene almacenamiento finito y una distribución por edades. Los trabajadores consumen memoria, ranuras de conexión y tiempo de ejecución. La dependencia tiene su propia capacidad y límite de permisos. Hacer visibles esas capas ayuda a explicar por qué aumentar el número de trabajadores no equivale a aumentar la capacidad de todo el servicio. Un límite en una capa puede superarse cuando la siguiente capa toma prestado de un grupo compartido ilimitado.
Tomemos como ejemplo un trabajador que se limita a una cantidad modesta de trabajos activos pero permite que cada trabajo abra muchas llamadas posteriores simultáneas. El límite de nivel superior parece responsable, pero el recurso que importa se multiplica por debajo de él. El mismo problema ocurre cuando un tiempo de espera libera un permiso a nivel de aplicación antes de que la operación subyacente haya dejado de consumir la dependencia. El limitador cuenta una cosa mientras el recurso paga otra. El diseño debe identificar el momento en que se adquiere un permiso, el trabajo que cubre y la observación que justifica su liberación.
El aislamiento es útil porque el trabajo no relacionado no debería perder toda su capacidad ante la dependencia más lenta. Los grupos separados o las asignaciones de concurrencia pueden evitar que una integración fallida ocupe los recursos que necesita una integración sana. Esto no es gratis. Las particiones pueden dejar capacidad inactiva mientras otra partición está ocupada, y demasiadas particiones pueden dificultar el ajuste del sistema. El valor es un límite de falla más predecible. La elección debe explicarse en términos de qué cargas de trabajo pueden afectarse entre sí, en lugar de presentar los mamparos como una instrucción universal para crear una cola y un grupo de subprocesos separados para cada función.
Un disyuntor toma una decisión diferente a la de una política de reintento. Puede detener temporalmente los intentos de acceso a un recurso que tiene suficientes probabilidades de fallar y permitir sondas controladas para evaluar la recuperación. El patrón de Microsoft describe esa separación. Para el servicio hipotético, la pregunta interesante es qué sucede alrededor del interruptor: si los intentos bloqueados consumen un presupuesto de reintento, si el trabajo de respaldo utiliza la misma dependencia fallida y si la población de la sonda permanece limitada en todas las instancias. Un interruptor dibujado en un diagrama de arquitectura no establece por sí solo esos comportamientos circundantes. [4]
Un recurso alternativo puede empeorar accidentalmente la situación. Si un error de caché envía todas las solicitudes a la dependencia original, una ruta de caché aparentemente resistente puede concentrar la carga durante un período de baja tasa de aciertos. Si un proveedor alternativo tiene una cuota menor, cambiar a todas las personas que llaman a la vez puede transferir el incidente. Si una respuesta degradada es costosa de calcular, es posible que no conserve suficiente capacidad para ser útil. Un respaldo debe evaluarse como otra carga de trabajo con sus propias dependencias y condiciones de corrección. Su nombre no es evidencia de que sea más barato, más seguro o esté disponible a la escala de la ruta primaria fallida.
También hay tareas para las que la información obsoleta es inaceptable. Devolver un resultado informativo más antiguo con una marca de tiempo visible puede ser una degradación razonable para algunos lectores. Utilizar una decisión de autorización antigua o presentar un estado empresarial obsoleto como actual puede suponer un riesgo diferente. La aplicación debe decidir qué partes del resultado pueden degradarse, cómo se comunica esa condición y qué operaciones deben rechazarse. Preservar la disponibilidad ocultando la incertidumbre puede dañar el negocio incluso cuando hace que el panel de tasa de errores se vea mejor. La respuesta al fracaso debe preservar una descripción veraz de lo que sabe el servicio.
El tratamiento que hace Google de la sobrecarga analiza las respuestas degradadas y la necesidad de rechazar un trabajo cuando ni siquiera se puede ofrecer una respuesta reducida. Esto proporciona un contexto útil para una elección de diseño que de otro modo puede parecer derrotista: rechazar algunas solicitudes puede proteger la capacidad de completar otras. No elige las prioridades comerciales para el hipotético servicio. Esas prioridades requieren un contrato explícito sobre qué tareas pueden esperar, cuáles pueden degradarse y cuáles deberían fallar rápidamente. Entonces, el mecanismo técnico necesita hacer cumplir ese contrato en lugar de limitarse a registrarlo en un documento. [5]
5. El retroceso cambia el tiempo; jitter cambia de empresa
Dos clientes pueden tener retrasos sensibles individualmente y aun así llegar juntos. Si una población grande falla en el mismo momento y cada miembro espera el mismo intervalo, su próxima ola puede permanecer sincronizada. Un retraso creciente cambia el espacio entre ondas sin necesariamente dispersar a los miembros de cada onda. Jitter introduce variación en su sincronización. La idea importante no es la aleatoriedad como complemento decorativo a una fórmula. Se trata de evitar una población en recuperación que se presenta repetidamente como una explosión coordinada. La distribución y los límites requeridos deben ajustarse al protocolo, los plazos y la carga de trabajo observada.
La discusión de AWS sobre el retroceso exponencial y la fluctuación ilustra por qué el tiempo determinista de reintento puede dejar grupos de trabajo. Eso respalda el mecanismo de sincronización, no una elección de parámetro universal para otro servicio. En la aplicación hipotética, una demora aleatoria más larga podría distribuir los intentos pero también empujar a algunos más allá del plazo útil de la persona que llama. Un rango más corto podría ajustarse al plazo y al mismo tiempo hacer muy poco para reducir la sincronización. El diseño necesita ambas restricciones. No debe tratar el nombre de un algoritmo elegido como prueba de que cada retraso generado es apropiado para la tarea. [6]
Un bucle de reintento también necesita una interpretación de la respuesta. Un error de autenticación, una regla de negocio rechazada y un límite de capacidad temporal no exigen el mismo comportamiento. Repetir una solicitud inválida sin cambios generalmente no puede reparar la información que la hizo inválida. Una respuesta de limitación puede proporcionar una guía de tiempo, pero la persona que llama aún debe respetar su propia fecha límite y su asignación agregada. Un fallo de conexión puede dejar la ejecución incierta. La clasificación debería conducir a una decisión sobre la operación, no simplemente a una búsqueda que asigne a cada excepción otro número de intentos.
El cronograma de intentos debe incluir el tiempo dedicado a realizar un trabajo útil, esperar una respuesta y esperar antes de otro intento. Una política puede parecer corta cuando sus retrasos se enumeran por separado, pero exceden el tiempo total asignado a la tarea una vez que se incluye la ejecución. También debe tener en cuenta los intentos superpuestos si la aplicación lo permite. La especulación paralela a veces puede reducir la latencia, pero para lograrlo gasta capacidad adicional. En condiciones de sobrecarga, esa compensación puede resultar particularmente costosa. Una organización debe saber cuándo el servicio toma esa decisión, qué operaciones califican y qué detiene el trabajo adicional.
El horario no es la única fuente de sincronización. El sondeo periódico, la actualización de tokens, los inicios de lotes programados y una flota de procesos que se reinician después de un evento compartido pueden concentrar la actividad. Por lo tanto, la interrupción hipotética podría repetirse incluso después de que se mejore el ciclo de reintento explícito. La útil investigación pregunta qué relojes se comparten en toda la carga de trabajo y qué acciones costosas desencadenan. Difundir el trabajo previo puede ayudar, pero los plazos, los horarios comerciales y las ventanas de servicio externo pueden limitar esa libertad. Una solución correcta cambia el patrón de llegada relevante manteniendo el propósito de la tarea programada.
La persona que llama y vuelve a presionar el botón.
Las personas pueden ser otra capa de reintento. Una pantalla que gira sin explicar si se aceptó una solicitud invita a volver a enviarla. Un botón deshabilitado puede reducir los duplicados accidentales, pero no puede establecer el estado del servidor después de una respuesta perdida. Una referencia de operación duradera y una vista de estado clara pueden brindarle al lector una forma de inspeccionar la primera solicitud en lugar de crear otra. La interfaz debe distinguir entre esperar una operación aceptada y pedirle al servidor que inicie una nueva operación. Esa distinción se vuelve especialmente valiosa cuando una fecha límite interactiva corta se encuentra frente a un proceso asincrónico más largo.
La redacción es importante porque el software hace una promesa. Decir que una solicitud falló cuando se desconoce su resultado fomenta una acción diferente a decir que se aceptó el procesamiento y se está verificando su estado. Ninguno de los mensajes debe pretender tener una certeza que el sistema no posee. La vista de estado también debe evitar convertirse en una fuente de sondeo incontrolada durante el incidente. Elegir el intervalo, almacenar en caché el estado cuando corresponda y limitar las actualizaciones repetidas son parte del mismo diseño de capacidad. Una experiencia de usuario útil ayuda a las personas a recuperar su intención sin convertir su incertidumbre en otra ola de trabajo.
6. El tráfico de recuperación necesita una ruta a casa
Un servicio controlado por colas introduce otra distinción: el procesamiento exitoso y el reconocimiento exitoso son eventos separados. El efecto comercial puede completarse antes de que el corredor sepa que el mensaje se puede eliminar. Si se pierde el reconocimiento, el sistema puede ver el mensaje nuevamente. Azure Service Bus documenta transferencias, bloqueos y liquidaciones como partes separadas de la entrega. La consecuencia arquitectónica es conectar la identidad de procesamiento del mensaje con la operación comercial y manejar la entrega repetida deliberadamente. Aumentar el umbral del recuento de entregas no establece que la ejecución repetida sea segura. [7]
El trabajador también necesita reconocer el trabajo que no será válido mediante la repetición. Una carga útil con formato incorrecto, una versión operativa no compatible o un requisito previo que falta permanentemente puede requerir corrección o investigación. Devolverlo indefinidamente a la cola activa puede gastar capacidad sin mejorar las posibilidades de éxito. Una ruta de falla separada puede mantener la carga de trabajo ordinaria en movimiento, pero esa ruta necesita un dueño y una consecuencia visible. Una cola de mensajes fallidos cuyo contenido nunca se examina no es una estrategia de recuperación; es una acumulación de promesas no resueltas que resultan estar fuera del gráfico principal de rendimiento.
La documentación de mensajes fallidos de Service Bus de Microsoft explica la función de la subcola secundaria y la necesidad de que las aplicaciones manejen sus mensajes. La elección importante para el servicio hipotético es lo que sucede antes de cualquier nuevo envío. El equipo necesita establecer si el defecto subyacente se corrigió, si la intención comercial original aún está vigente y si un intento anterior ya causó un efecto. Una repetición masiva que omita esas preguntas puede convertir la vieja incertidumbre en una nueva carga. El procedimiento de recuperación debería ser capaz de seleccionar el trabajo, en lugar de tratar cada mensaje almacenado como igualmente seguro para ejecutarlo nuevamente. [8]
Cuando la capacidad regresa, la demanda viva y el trabajo de recuperación histórico compiten. Un servicio que agota todas las tareas antiguas a la tarifa máxima disponible puede causar a los usuarios actuales una segunda interrupción. Es posible que un servicio que reserva todo para nuevos trabajos nunca elimine el trabajo atrasado. Por lo tanto, la tasa de liberación para los trabajos de recuperación necesita una política vinculada a la capacidad sobrante real y a la prioridad empresarial. Se puede ajustar a medida que cambia el comportamiento de la dependencia. Lo esencial es que la recuperación es una carga de trabajo en sí misma, no una categoría especial exenta de los límites aplicados al tráfico ordinario.
La decisión de recuperación también tiene una condición de detención. Es posible que una repetición deba pausarse cuando aumenta la latencia, cuando la solicitud en vivo más antigua excede su edad útil, cuando la detección de duplicados encuentra un patrón inesperado o cuando una dependencia comienza a acelerarse nuevamente. Las señales relevantes dependen del servicio. Lo que importa es que la persona o el mecanismo que libera el trabajo antiguo pueda observarlo y actuar antes de que el amortiguador se convierta en la fuente de otra oleada. Un comando de repetición sin una ruta de retroalimentación ofrece persistencia, pero poco control sobre sus consecuencias.
Preservar la procedencia hace que esa retroalimentación sea más útil. Una operación debe ser rastreable desde su primer envío, intentos posteriores, entregas en cola y cualquier corrección manual. No es necesario que los identificadores expongan contenido confidencial para lograrlo. Necesitan una relación estable con la intención comercial y suficiente contexto de configuración para explicar la política bajo la cual se ejecutó cada intento. Sin esa continuidad, un equipo puede dedicar su respuesta a incidentes a decidir si se trata de una operación obstinada, muchas solicitudes nuevas o una combinación de ambas. El volumen adicional de tala se convierte entonces en otra presión sobre los recursos sin brindar la comprensión necesaria.
7. Busque el trabajo que se está haciendo
Un servicio puede estar ocupado, disponible y al mismo tiempo inútil. La CPU, la utilización de la conexión y la tasa de solicitudes describen la actividad, mientras que las terminaciones útiles describen el progreso. Ninguna categoría reemplaza a la otra. La observación interesante es cómo divergen. Si los intentos aumentan mientras que las operaciones únicas completadas disminuyen, es posible que el servicio esté gastando más para lograr menos. Si la latencia mejora sólo porque se rechaza una fracción mayor del trabajo, es posible que la aplicación haya protegido sus recursos y aún así falle a muchos lectores. La visión operativa debería hacer visibles ambos hechos en lugar de elegir la métrica que cuente la historia más tranquilizadora.
El denominador es particularmente importante para una aplicación que vuelve a intentarlo. Una tasa de éxito a nivel de intento puede verse distorsionada por el número de intentos por operación. Una tasa de finalización a nivel de usuario puede ocultar la cantidad de consumo de recursos necesarios para producir cada éxito. Un panel útil separa la demanda original, el total de intentos, el trabajo admitido, las operaciones únicas completadas, el tiempo hasta la finalización útil y los resultados que siguen siendo inciertos. También muestra la edad y la clase de carga de trabajo donde esas distinciones afectan la decisión. Estas medidas describen diferentes preguntas; recopilarlos es útil sólo cuando el equipo puede conectar un cambio en ellos con una acción.
Una proporción de diagnóstico son los intentos de llamadas de dependencia por operación original. Otro es la proporción del escaso tiempo de ejecución dedicado a operaciones cuyo plazo de inicio ya ha expirado. Ninguno de los dos debería tratarse como un objetivo de nivel de servicio universal. Son formas de hacer visible un mecanismo sospechoso. La definición debe ser lo suficientemente precisa como para evitar contar la recuperación de una conexión inofensiva como una ejecución comercial adicional o tratar una tarea intencionalmente asincrónica como un trabajo abandonado. La medida es valiosa cuando discrimina entre explicaciones, no cuando proporciona otra línea atractiva en el tablero de incidentes.
El costo es parte de esa observación. Los intentos adicionales pueden aumentar los cargos por solicitudes, el volumen de registros, la pérdida de conexiones o el consumo de cómputo incluso cuando no completan más trabajo comercial. El costo por solicitud puede parecer mejorar si el denominador crece con los reintentos, mientras que el costo por resultado útil se deteriora. La organización necesita una visión de costos que siga la tarea lo suficiente como para incluir esfuerzos fallidos y repetidos. Aquí no se reclaman ahorros. La cuestión es elegir un límite contable que revele si un cambio de resiliencia propuesto reduce el desperdicio en lugar de simplemente trasladarlo a otro servicio o factura.
Pruebe la cadena, no solo el bucle
Un reintento exitoso en una prueba unitaria establece muy poco sobre una flota con falla correlacionada. Una prueba controlada más reveladora cambia la latencia o la capacidad de finalización de una dependencia mientras mantiene identificable la demanda original. Observa si los intentos de amplificación permanecen limitados, si los plazos finalizan el trabajo según lo previsto y si el rendimiento útil se recupera después de la perturbación. El entorno y los límites deberían hacer que esa prueba sea segura. El objetivo no es provocar un incidente de producción descontrolado para demostrar dureza. Se trata de desafiar la suposición específica de que los intentos adicionales siguen siendo útiles cuando muchas personas que llaman fallan juntas.
Los escenarios deben distinguir entre respuestas lentas, rechazos definitivos y resultados desconocidos. Deben incluir una dependencia que se recupere antes de la fecha límite de la persona que llama y otra que no. Un servicio basado en colas también debería tener incertidumbre en el reconocimiento, trabajo vencido y una repetición deliberadamente limitada. El resultado esperado no es simplemente que cada tarea enviada finalmente tenga éxito. Algunas tareas deben rechazarse o dejar de intentarse. La pregunta significativa es si el resultado observado coincide con el contrato, mientras el recurso restringido permanece protegido y la organización puede explicar qué sucedió con cada clase de trabajo.
Una comparación necesita la misma demanda original. De lo contrario, es posible que una configuración que parece recuperarse más rápido simplemente haya recibido una carga de trabajo más sencilla. La cuenta debe conservar el patrón de llegada, la combinación de tareas, la condición de dependencia y las versiones de configuración relevantes para el resultado. Debe distinguir los ejemplos calculados, como el cuadro de este artículo, de las mediciones obtenidas en una prueba en ejecución. Repetir una historia numérica plausible como si fuera un punto de referencia debilitaría la evidencia. Un modelo pequeño y transparente es útil porque sus supuestos pueden cuestionarse, no porque sus líneas suaves se parezcan a una traza de producción.
8. El sistema al que se le permite dejar de intentarlo
Regrese a la primera solicitud retrasada. No tenía por qué convertirse en un apagón. La cadena de fallas adquirió su fuerza a través de varias transiciones: un tiempo de espera se interpretó como un permiso para comenzar más trabajo; capas de intentos multiplicados sin un presupuesto común; el trabajo en espera ocultaba una brecha de capacidad cada vez mayor; y el tráfico de recuperación se trató como si su urgencia creara un rendimiento adicional. Cada transición ofrece un lugar para interrumpir la cadena. El diseño no necesita todos los patrones de resiliencia posibles. Necesita controles en los puntos donde este servicio puede convertir la incertidumbre en una carga adicional o en un efecto comercial repetido.
Hay circunstancias en las que otro intento es exactamente la respuesta correcta. Una breve falla independiente puede desaparecer, una lectura segura puede completarse rápidamente en otra ruta o un reenvío limitado puede recuperar una tarea valiosa. El argumento no está en contra de la persistencia. Es por la perseverancia que responde al tiempo, a la capacidad y al sentido de la operación. Un servicio debería poder explicar por qué se hizo un intento, qué asignación se pagó por ello y qué observación impediría el siguiente. Esa explicación es más útil que una afirmación genérica de que se han habilitado los reintentos para garantizar la confiabilidad.
Por lo tanto, la capacidad de recuperación más importante puede ser la capacidad de detenerse. Deja de crear intentos cuando el plazo haya inutilizado su resultado. Dejar de tomar prestada capacidad de trabajos no relacionados. Deje de reproducir un trabajo pendiente cuando el servicio en vivo comience a verse afectado. Deje de alegar un fracaso definitivo cuando aún se desconoce el resultado de la ejecución. Se trata de decisiones diferentes y cada una necesita un propietario o mecanismo adecuado. Juntos hacen espacio para que la dependencia subyacente se recupere y para que la organización corrija el trabajo que queda, en lugar de obligar a todas las intenciones no resueltas a regresar por el mismo camino sobrecargado.
Un servicio confiable no promete durar para siempre. Hace una promesa más práctica: el trabajo aceptado tiene un significado definido, el esfuerzo adicional tiene un límite y un fracaso produce un resultado que la gente puede entender y actuar en consecuencia. Cuando esas condiciones se mantienen, los reintentos pueden seguir siendo una herramienta útil en lugar de convertirse en una carga de trabajo invisible sin un cliente responsable. La diferencia aparece más claramente durante la recuperación. A medida que la falla original desaparece, el sistema tiene suficiente control sobre su propio comportamiento para permitir que se reanude el trabajo útil.