Zuverlässige Systeme
Wenn Wiederholungsversuche zum Ausfall führen
Eine kleine Verlangsamung kann zu einem systemweiten Ausfall führen, wenn jede Ebene versucht, sich selbstständig zu erholen. Folgen Sie der Kette – und den Grenzen, die sie stoppen können.
Folgen Sie der Fehlerkette
- 1. Eine kleine Verzögerung erhält ein zweites Leben
- 2. Die Multiplikation erfolgt zwischen Teams
- 3. Wartezimmer schaffen keine Kapazitäten
- 4. Erstellen Sie eine Grenze, durch die die Überlastung keine Kredite aufnehmen kann
- 5. Backoff ändert den Zeitpunkt; Jitter verändert das Unternehmen
- 6. Der Erholungsverkehr braucht eine Route nach Hause
- 7. Suchen Sie nach der Arbeit, die erledigt wird
- 8. Das System, das es nicht mehr versuchen darf
Eine Absicht, siebenundzwanzig mögliche Versuche
Öffnen Sie das Bild in voller Größe ↗Erklärung und Annahmen
Veranschaulichende Verzweigung im schlimmsten Fall: drei Ebenen, die jeweils drei Gesamtversuche einschließlich des Originals ermöglichen. Kein vorzeitiger Erfolg oder Abbruch; Der tatsächliche Datenverkehr hängt von der Implementierung ab. Ringflächen sind kein Maß für die Arbeitsbelastung.
Die erste fehlgeschlagene Anfrage ist oft der uninteressanteste Teil eines Ausfalls. Eine Abhängigkeit dauert länger als erwartet, ein Anrufer gibt das Warten auf und die Anwendung versucht es erneut. Das sieht nach einer sinnvollen Sanierungsmaßnahme aus. Die Schwierigkeit tritt auf, wenn Tausende anderer Anrufer zum gleichen Schluss kommen, mehrere Ebenen ihre eigenen Versuche unternehmen und die ursprüngliche Arbeit noch läuft. Das System verwendet nun einen wachsenden Teil seiner Kapazität für die Wiederherstellung nach der durch seine Wiederherstellungsmechanismen verursachten Last. Nichts in einer einzelnen Wiederholungsschleife muss offensichtlich unvernünftig aussehen, damit das kombinierte Verhalten destruktiv wird.
Stellen Sie sich einen explizit hypothetischen Bestellstatusdienst vor. Normalerweise verfügt es über genügend Kapazität für die eingehende Arbeit, aber eine Downstream-Abhängigkeit verlangsamt sich für zwei Minuten. Anforderungen bleiben länger in Bearbeitung, das Zeitlimit des Anrufers beginnt abzulaufen und eine Clientbibliothek startet einen weiteren Versuch. Ein äußerer Dienst verfügt ebenfalls über eine Wiederholungsrichtlinie. Eine Benutzeroberfläche bietet eine Schaltfläche „Wiederholen“ an, da die eigene Frist abgelaufen ist. Die Geschäftsanforderungen haben sich kaum verändert, doch die Abhängigkeit sieht mehr Arbeitsversuche vor, wenn sie weniger erledigen kann. Dieser Artikel folgt dieser Kette und untersucht dann die Stellen, an denen ein Design sie unterbrechen kann. Das Szenario und jedes numerische Beispiel dienen der Veranschaulichung und stellen keinen Bericht über einen MGCA-Kundenvorfall oder einen gemessenen Benchmark dar.
Ein Wiederholungsversuch ist eine neue Anforderung von Ressourcen, auch wenn es sich dabei um eine alte Absicht handelt. Diese Unterscheidung ist der Ausgangspunkt für das Verständnis des Scheiterns. Das Unternehmen möchte möglicherweise noch eine Statusaktualisierung, einen eingereichten Antrag oder einen abgeschlossenen Bericht. Die Infrastruktur verarbeitet möglicherweise mehrere Versuche, es zu erstellen. Wenn Dashboards Anfragen zählen, ohne sie mit dem zugrunde liegenden Vorgang zu verknüpfen, kann die zusätzliche Aktivität wie ein Anstieg der Kundennachfrage aussehen. Wenn der Erfolg pro Versuch und nicht pro nützlichem Ergebnis gemessen wird, kann die Dienstleistung auch gesünder erscheinen als die Erfahrung der Person, die darauf wartet.
1. Eine kleine Verzögerung erhält ein zweites Leben
Ein Timeout beantwortet eine lokale Frage: Wie lange wird dieser Anrufer warten? Es gibt keine Antwort darauf, ob der Remote-Vorgang gestoppt wurde, vor der Ausführung fehlgeschlagen ist oder abgeschlossen wurde, ohne dass eine Bestätigung übermittelt wurde. Das sind unterschiedliche Ergebnisse. Bei einem Lesevorgang kann die Wiederholung der Anforderung hauptsächlich Ressourcen verbrauchen. Bei einem Schreibvorgang kann ein unsicheres Ergebnis auch zu einem Korrektheitsproblem führen. Das empfangende System hat die Änderung möglicherweise bereits festgeschrieben. Der Wunsch des Anrufers, eine eindeutige Antwort zu erhalten, macht eine weitere Hinrichtung nicht sicher. Kapazitätsschutz und geschäftliche Korrektheit müssen daher gemeinsam betrachtet werden, anstatt Wiederholungsversuche einer Transportschicht zuzuweisen und davon auszugehen, dass der Rest der Anwendung davon unberührt bleibt.
Die erste Reaktion auf eine Verlangsamung ist oft eine Verlängerung des Timeouts. Dadurch können Fehlausfälle reduziert werden, bei denen die normale Variation fälschlicherweise mit einem Ausfall verwechselt wurde. Es kann auch dazu führen, dass mehr Anfragen länger Ressourcen belegen. Eine Verringerung des Timeouts führt zu dem gegenteiligen Kompromiss: Anrufer geben ihren Wartezustand früher auf, können jedoch Ersatzversuche einleiten, während die vorherige Arbeit aktiv bleibt. Keine der beiden Richtungen ist grundsätzlich korrekt. Die sinnvolle Frage ist, welche Ressourcen weiterhin belegt sind, welche Arbeiten tatsächlich eingestellt werden und wie sich die gewählte Frist auf den Wert der Erledigung der Aufgabe auswirkt. Wenn Sie eine Zahl ändern, ohne diese Fragen zu beantworten, kann dies den Druck eher erhöhen als beseitigen.
Es gibt auch mehr als eine Uhr. Das Herstellen einer Verbindung, das Auflösen eines Namens, das Erhalten eines Identitätstokens, das Warten auf eine gepoolte Verbindung und das Empfangen der Antwort können jeweils einen Teil der verfügbaren Zeit des Anrufers in Anspruch nehmen. Ein Anforderungszeitlimit, das eine frühere Wartezeit ausschließt, kann einen irreführenden Eindruck vom Gesamtvorgang vermitteln. Umgekehrt können unabhängig voneinander großzügige Zulagen in jeder Phase zu einer Gesamtverzögerung führen, die weit über das Versprechen gegenüber dem Benutzer hinausgeht. Ein Entwurf benötigt eine kohärente Darstellung der verstrichenen Zeit, einschließlich der Zeit, die vor Beginn des Fernanrufs und zwischen den Versuchen verbracht wurde. Die wichtige Grenze ist die gesamte Aufgabe und nicht der Timer, der gerade am einfachsten zu konfigurieren ist.
Stellen Sie sich im hypothetischen Dienst vor, dass die sichtbare Seite nach fünf Sekunden aufhört zu warten, während ein innerer Klient zwanzig Sekunden lang weitermachen darf. Bei diesen Werten handelt es sich nicht um empfohlene Einstellungen. Sie offenbaren ein Eigentumsproblem. Während eines Teils dieses Zeitraums arbeitet der Dienst möglicherweise an einer Anfrage, deren ursprünglicher Leser die Website bereits verlassen hat. Wenn die Seite einen neuen Vorgang übermittelt, konkurrieren die alte Arbeit und die neue Arbeit. Wenn der Abbruch weitergegeben wird, muss die empfangende Komponente noch definieren, was sie sicher abbrechen kann. Das Stoppen einer Netzwerkwartezeit und das Rückgängigmachen einer festgeschriebenen Transaktion sind nicht dieselben Funktionen. Eine Frist kann die Nützlichkeit eines Ergebnisses beenden, ohne seine Auswirkungen rückgängig zu machen.
Der erste Unterbrechungspunkt ist somit eine Frist, die einen Eigentümer hat. Eine Komponente sollte wissen, wie viel von der verbleibenden Zeit der Operation sie möglicherweise benötigt, ob ein weiterer Versuch innerhalb dieser Zeit plausibel abgeschlossen werden kann und was passiert, wenn diese Zeit erschöpft ist. Die Antwort kann ein eindeutiger Fehler, ein beibehaltener asynchroner Vorgang mit einem Statusverweis oder ein als unvollständig markiertes Ergebnis sein. Es sollte keine unsichtbare Übertragung derselben Arbeit in eine andere unbegrenzte Wiederholungsschleife erfolgen. Eine Wiederherstellungsrichtlinie ist nützlich, wenn sie die Chance auf ein gültiges Ergebnis innerhalb der tatsächlichen Einschränkungen der Aufgabe erhöht.
In den technischen Leitlinien von Amazon werden Zeitüberschreitungen, Backoffs, Jitter und das Risiko erörtert, dass ein Anruf mit Zeitüberschreitung bereits Nebenwirkungen hervorgerufen hat. Microsoft beschreibt das damit verbundene Retry-Storm-Antipattern: Häufige Versuche können die Wiederherstellung eines Dienstes mit Schwierigkeiten verhindern. Diese Quellen unterstützen den allgemeinen Mechanismus, anstatt die einzelnen Zahlen in diesem Artikel zu validieren. Die folgende Design-Argumentation wendet diesen Mechanismus auf einen bewusst vereinfachten Dienst an, sodass die Konsequenzen überprüfbar bleiben. [1] [2]
2. Die Multiplikation erfolgt zwischen Teams
Drei Versuche klingen bescheiden. Drei Schichten, die jeweils drei Gesamtversuche ermöglichen, können sehr unterschiedlich sein. Unter der spezifischen Worst-Case-Annahme, dass jeder äußere Versuch alle inneren Versuche verursacht und keiner frühzeitig erfolgreich ist, kann die tiefste Abhängigkeit siebenundzwanzig Versuche für einen ursprünglichen Vorgang erhalten. Dabei handelt es sich um eine Multiplikation in der gesamten Anrufhierarchie und nicht um die Behauptung, dass jeder Fehler automatisch zu dieser Anzahl führt. Stornierung, Fristen, vorzeitiger Erfolg, Schaltungsstatus und die tatsächliche Eigentümerschaft des Wiederholungsversuchs können dies verringern. Der Zweck der Berechnung besteht darin, eine Interaktion aufzudecken, die leicht übersehen wird, wenn jede Komponente einzeln überprüft wird.
Hier kommt es auf die Terminologie an. Eine Einstellung, die als drei Wiederholungsversuche beschrieben wird, kann einen ursprünglichen Versuch plus drei weitere bedeuten, während drei Versuche den ursprünglichen Versuch einschließen. Wenn diese Definitionen verwechselt werden, ändert sich die Berechnung, bevor irgendwelche Implementierungsdetails in sie eingehen. In einer Architekturdiskussion sollten die insgesamt zulässigen Versuche an jeder Grenze notiert und ermittelt werden, welche Komponente sie startet. Es sollte auch das von Client-Bibliotheken, Gateways und der Infrastruktur bereitgestellte Verhalten umfassen. In einem Diagramm, das nur Anwendungscode zeigt, kann der Wiederholungsmechanismus, der den Datenverkehr dominiert, weggelassen werden. Die Komponente, die einen Fehler vor dem Aufrufer verbirgt, trägt dennoch zur Systemauslastung bei.
Die organisatorische Ursache ist verständlich. Jedes Team möchte, dass sein eigener Dienst eine kurze Unterbrechung toleriert. Eine gemeinsam genutzte Bibliothek übernimmt eine Standardrichtlinie. Ein Gateway fügt eine weitere Schutzebene hinzu. Ein Worker betrachtet eine Ausnahme als Grund, die Nachricht abzubrechen und erneut zu empfangen. Keine dieser Entscheidungen muss nachlässig sein. Der Fehler tritt auf, weil die Richtlinien eine gemeinsame Abhängigkeit ohne gemeinsames Budget haben. Aus lokaler Widerstandsfähigkeit ist kollektiver Optimismus geworden: Jeder Teilnehmer geht davon aus, dass ein weiterer Versuch erschwinglich ist, während kein Teilnehmer für die Gesamtzahl der Versuche verantwortlich ist, die der Geschäftsbetrieb generieren kann.
Das Radialdiagramm an der Öffnung macht dies sichtbar. Seine Ringe repräsentieren eine ursprüngliche Operation, dann drei, neun und siebenundzwanzig mögliche Downstream-Versuche in einem bewusst eingeschränkten Modell. Bei den Ringen handelt es sich nicht um gemessenen Verkehr und ihre Flächen sind keine Leistungsschätzungen. Sie sind eine Möglichkeit, die Verzweigungsannahme zu überprüfen, ohne eine weitere rechteckige Anwendungslandschaft zu zeichnen. Verfolgen Sie eine einzige Absicht nach außen und fragen Sie, wo neue Arbeit entsteht. Wenn mehrere Schichten sie unabhängig voneinander erweitern können, lässt sich durch die Überprüfung nur der maximalen Wiederholungsversuche des letzten Clients nicht die maximale Belastung ermitteln, die die gesamte Route verursachen kann.
Eine praktische Antwort besteht darin, die Wiederholungseigentümerschaft an der Grenze explizit zu machen, an der die Anwendung über genügend Kontext verfügt, um den Vorgang zu beurteilen. Das bedeutet nicht, dass jedes System die gesamte Resilienzlogik an einem Ort zentralisieren sollte. Ein Transport kann eine unterbrochene Verbindung sinnvoll wiederherstellen, während eine Anwendung eine längere Aufgabe verwaltet. Voraussetzung ist, dass ihr gemeinsames Verhalten verstanden und begrenzt wird. Eine untere Schicht sollte nicht stillschweigend eine vollständige Geschäftsaktion starten, nachdem die obere Schicht glaubt, dass sie das Aufgabenbudget erschöpft hat. Die Grenze zwischen erneutem Verbinden, erneutem Senden und erneuter Ausführung muss sowohl im Design als auch in der Beobachtung sichtbar sein.
Ein Wiederholungsbudget fügt ein zweites Limit hinzu, das über das Maximum pro Anfrage hinausgeht. Die Anwendung kann die Gesamtmenge an zusätzlicher Arbeit begrenzen, die sie bei einem Fehler verursacht. Die Abrechnungseinheit muss bewusst gewählt werden: Anfragen, gleichzeitige Versuche, verstrichene Zeit, gewichtete Kosten oder eine Kombination. Ein billiger zwischengespeicherter Lesevorgang und ein teurer Bericht sind nicht unbedingt austauschbare Token. Der Mechanismus sollte auch festlegen, was passiert, wenn das Budget leer ist. Durch einfaches Verschieben abgelehnter Wiederholungsversuche in eine private Warteschlange bleibt der Druck erhalten, während er vor dem ursprünglichen Begrenzer verborgen bleibt. Ein sinnvolles Budget verändert das Verhalten, das die eingeschränkte Ressource erreicht.
Es gibt keinen allgemeingültigen Prozentsatz, der ein solches Budget korrekt macht. Die verfügbare Wiederherstellungskapazität, der Abhängigkeitsvertrag, der Aufgabenwert und das Fehlerverhalten unterscheiden sich. Ein Dienst kann für kurze, vorübergehende Fehler nur einen begrenzten Spielraum reservieren, während er sich weigert, bei anhaltenden Fehlern eine Vervielfachung kostspieliger Arbeiten durchzuführen. Ein anderer könnte berechtigte Aufgaben an einen separat kontrollierten Hintergrundprozess verlagern. Entscheidend ist, dass die Richtlinie auch dann sinnvoll bleibt, wenn das System überlastet ist, wenn die Erfolge gering sind und wenn mehrere Anrufer gemeinsam scheitern. Ein Budget, dessen Wiederauffüllung vom Erfolg abhängt, benötigt eine explizite Interpretation dieses Zeitraums mit geringem Erfolg und nicht eine versehentliche Sperrung oder eine unbegrenzte Notfallüberbrückung.
Ein gescheiterter Versuch ist keine neue Geschäftsanweisung
Für einen schreibfähigen Dienst muss die Identität des Vorgangs den Versuch überstehen. Wenn ein Client jedes Mal, wenn er dieselbe Absicht erneut sendet, eine neue Geschäftskennung generiert, kann ein Empfänger die Anforderungen vernünftigerweise als unterschiedliche Vorgänge behandeln. Wenn ein Bezeichner wiederverwendet wird, ohne den zugehörigen Inhalt zu überprüfen, kann derselbe Schlüssel an wesentlich unterschiedliche Änderungen angehängt werden. Ein Idempotenzentwurf benötigt daher mehr als ein Feld mit dem Namen „Anfrage-ID“. Es braucht einen Geltungsbereich, eine Beziehung zur beabsichtigten Aktion, einen Aufbewahrungszeitraum und eine definierte Reaktion, wenn eine wiederholte Kennung mit inkompatiblem Inhalt eintrifft.
Ebenso wichtig ist die Ergebnisaufzeichnung. Wenn der Empfänger einen abgeschlossenen Vorgang identifizieren kann, sein Ergebnis jedoch nicht wiederherstellen kann, bleibt der Aufrufer möglicherweise unsicher, obwohl eine doppelte Ausführung verhindert wird. Der Dienst sollte entscheiden, ob er das vorherige Ergebnis zurückgeben, eine Statusreferenz bereitstellen oder eine Untersuchung anfordern kann. Die richtige Anordnung hängt vom Betrieb und seinen Informationsverarbeitungsanforderungen ab. Die allgemeine Unterscheidung ist stabil: Das Erkennen einer alten Anweisung, das Verhindern eines anderen Effekts und das Erklären des vorhandenen Effekts sind verwandte Fähigkeiten, werden aber nicht automatisch durch denselben Mechanismus bereitgestellt.
3. Wartezimmer schaffen keine Kapazitäten
Eine Warteschlange kann die Kontrolle einer Arbeitslast erleichtern. Es trennt die Annahme von der Ausführung und gibt den Verbrauchern die Möglichkeit, die Arbeit in einem nachhaltigen Tempo abzuwickeln. Es kann auch ein wachsendes Versprechen verbergen, das der Dienst nicht erfüllen kann. Die Warteschlangentiefe ist daher weder eine Erfolgsmetrik noch eine alleinige Erklärung. Eine Warteschlange mit zehn langsamen Berichten kann mehr Arbeit bedeuten als eine mit tausend kleinen Aktualisierungen. Eine kurze Warteschlange dringender Anfragen kann bereits zu alt sein. Die nützliche Beobachtung verbindet den Rückstand mit den Servicekosten, der Fertigstellungsfähigkeit und der Zeit, nach deren Ablauf das Ergebnis seinen Geschäftswert verliert.
Das warteschlangenbasierte Lastausgleichsmuster von Microsoft beschreibt die Verwendung eines Puffers zur Glättung der Nachfrage und unterstreicht die Notwendigkeit, die nachgelagerte Verarbeitung zu kontrollieren. Das Muster ändert sich, wenn dem Dienst Arbeit angeboten wird; es stellt keinen Durchsatz her. Diese Grenze ist wichtig, wenn man sie auf die hypothetische Verlangsamung anwendet. Wenn der Verbraucher die Warteschlange bei Rückkehr der Kapazität einfach so schnell wie möglich leert, kann er den ursprünglichen Anstieg wiederherstellen. Wenn Autoscaling-Konsumenten den Druck auf eine weiterhin eingeschränkte Abhängigkeit erhöhen, hat die Warteschlange die Überlastung verschoben, anstatt sie aufzulösen. Die aus dem Puffer freigegebene Menge benötigt eine eigene Betriebsgrenze. [3]
Die Kapazität kann wiederhergestellt werden, während der Rückstand weiter wächst
Öffnen Sie das Bild in voller Größe ↗Erklärung und Annahmen
Kapazität: 60 Einheiten/s für 120 Sekunden, dann 100 Einheiten/s. Ursprünglicher Rückstand: Null. Zusätzliche Versuche im Sensitivitätsfall: 40 Einheiten/s.
Sehen Sie sich die Berechnungsdaten an ↗Das Diagramm verwendet ein bewusst einfaches Fluidmodell. Der ursprüngliche Bedarf beträgt achtzig Arbeitseinheiten pro Sekunde. Die Verarbeitungskapazität sinkt in den ersten einhundertzwanzig Sekunden auf sechzig und kehrt dann auf einhundert zurück. Jede Einheit hat die gleichen angenommenen Kosten. Der anfängliche Rückstand ist Null, der Speicher hat in dieser Berechnung keine einschränkende Wirkung und keine Arbeit läuft ab oder schlägt dauerhaft fehl. Diese Annahmen machen die Arithmetik transparent. Sie beschreiben nicht das vollständige Verhalten eines echten Brokers, einer Datenbank, eines Netzwerks oder einer Anwendung. Der Zweck besteht darin, zu zeigen, wie sich eine unveränderte Geschäftsauslastung erholen kann, während eine erhöhte Arbeitsauslastung weiterhin zurückbleibt.
Da in dieser modellierten Warteschlange kein zusätzlicher Versuchsverkehr zugelassen wird, sammeln sich während der Verlangsamung jede Sekunde zwanzig Einheiten an. Nach zwei Minuten beträgt der Rückstand zweitausendvierhundert. Sobald die Kapazität wieder bei 100 liegt, während die neue Nachfrage bei 80 bleibt, verfügt der Dienst über zwanzig Einheiten freie Verarbeitungskapazität pro Sekunde. Die Beseitigung des Rückstands dauert daher noch einmal zwei Minuten. Zweihundertvierzig Sekunden nach dem Start ist die Warteschlange leer. Die Wiederherstellung erfolgt nicht sofort, wenn die Kapazität wiederhergestellt ist: Der Dienst muss zunächst die Arbeit zurückzahlen, die er angenommen hat, als er langsamer war als die ankommende Leistung.
Fügen Sie nun über das gesamte angezeigte Intervall angenommene vierzig Versuchseinheiten pro Sekunde hinzu. Dies ist ein Sensitivitätsfall und keine Vorhersage eines bestimmten Wiederholungsalgorithmus. Während der Verlangsamung werden die Ankünfte einhundertzwanzig gegenüber sechzig, so dass sich bis zum Zwei-Minuten-Punkt siebentausendzweihundert Einheiten ansammeln. Nachdem die Kapazität wieder auf einhundert zurückgekehrt ist, übersteigen die Ankünfte immer noch die Fertigstellungen um zwanzig. Nach sechs Minuten hat der Rückstand zwölftausend erreicht, anstatt sich zu erschöpfen. Die zusätzliche Nachfrage wird in diesem Vergleich konstant gehalten, um ihre Wirkung zu isolieren. Eine echte Wiederholungspopulation ändert sich mit Fristen, Backoff, erfolgreichen Abschlüssen und den Kontrollen, die die Anwendung anwendet.
Die beiden Spuren werden nach derselben Regel berechnet: Der Rückstand darf nicht negativ sein und ändert sich mit der zugelassenen Arbeit abzüglich der abgeschlossenen Arbeit. Ihre unterschiedlichen Ergebnisse beweisen nicht, dass jeder erneute Versuch schädlich ist. Ein gut gewählter Versuch nach einem kurzen unabhängigen Fehlschlag kann eine wertvolle Aufgabe wiederherstellen. Die Spuren zeigen, warum ein Versuch anhand der verfügbaren Kapazität bewertet werden muss. Wenn der eingeschränkte Dienst die zusätzliche Last nicht verarbeiten kann, kann eine höhere Beharrlichkeit den Zeitraum verlängern, in dem niemand ein zeitnahes Ergebnis erhält. Die Reduzierung des zusätzlichen Datenverkehrs kann eine Wiederherstellungsmaßnahme sein, selbst während die zugrunde liegende Abhängigkeit noch repariert wird.
Die Unterscheidung zwischen angebotener und zugelassener Ladung ist wesentlich. Ein Begrenzer sieht möglicherweise eine große Anzahl von Anfragen, lässt aber nur einige in die Arbeitswarteschlange zu. Abgelehnte Versuche kosten an der Grenze immer noch etwas, daher muss der Zulassungsweg kostengünstig genug sein, um unter Druck zu funktionieren. Sie sollten nicht denselben kostspieligen Abhängigkeitsaufruf durchführen, nur um zu entscheiden, ob er abgelehnt werden soll. Gleichzeitig ist eine billige Absage keine erledigte Kundenaufgabe. Der Dienst sollte Nachfrage, Zulassungen, Ablehnungen und nützliche Abschlüsse separat beobachten, damit eine scheinbare Reduzierung des Warteschlangenwachstums nicht mit einer erfolgreichen Erfüllung verwechselt wird.
Das Warteschlangenalter fügt die fehlende Zeitdimension hinzu. Angenommen, ein bestimmter Bericht ist nur vor einer Entscheidungsbesprechung nützlich. Die Bearbeitung nach der Besprechung hat möglicherweise nur einen geringen Wert, selbst wenn das System schließlich einen Erfolg meldet. Das Aufbewahren dieser Arbeit auf unbestimmte Zeit kann neuere, noch wichtige Aufgaben verzögern. Der Ablauf muss jedoch eine Geschäftsentscheidung mit sichtbarem Ergebnis sein und darf nicht stillschweigend Arbeiten zur Verbesserung eines Diagramms löschen. Der Anrufer muss wissen, ob die Anfrage zur Vervollständigung angenommen, abgelehnt, ersetzt oder abgelaufen ist. Eine stabile Warteschlange, die durch den Verzicht auf den Vertrag erreicht wird, ist kein wiederhergestellter Dienst.
Die gleiche Argumentation erschwert die Priorität. Dringenden Aufgaben den Vorrang zu geben, kann wichtige Ergebnisse schützen, aber ein ständiger Strom dringender Arbeit kann alles andere zum Erliegen bringen. Fairness zwischen Mandanten, Vorgängen und Arbeitslastklassen erfordert eine explizite Richtlinie. Eine einzelne globale First-In-First-Out-Warteschlange ist möglicherweise einfach zu bedienen, bietet aber nur eine geringe Isolation. Viele kleine Warteschlangen können die Trennung verbessern und gleichzeitig die Komplexität der Überwachung und Planung erhöhen. Die sinnvolle Wahl hängt davon ab, welche Parteien sich eine knappe Ressource teilen und welche Versprechen die Organisation verteidigen kann, wenn der Gesamtbedarf nicht sofort gedeckt werden kann.
4. Erstellen Sie eine Grenze, durch die die Überlastung keine Kredite aufnehmen kann
Vier verschiedene Limits, ein Service
Öffnen Sie das Bild in voller Größe ↗Erklärung und Annahmen
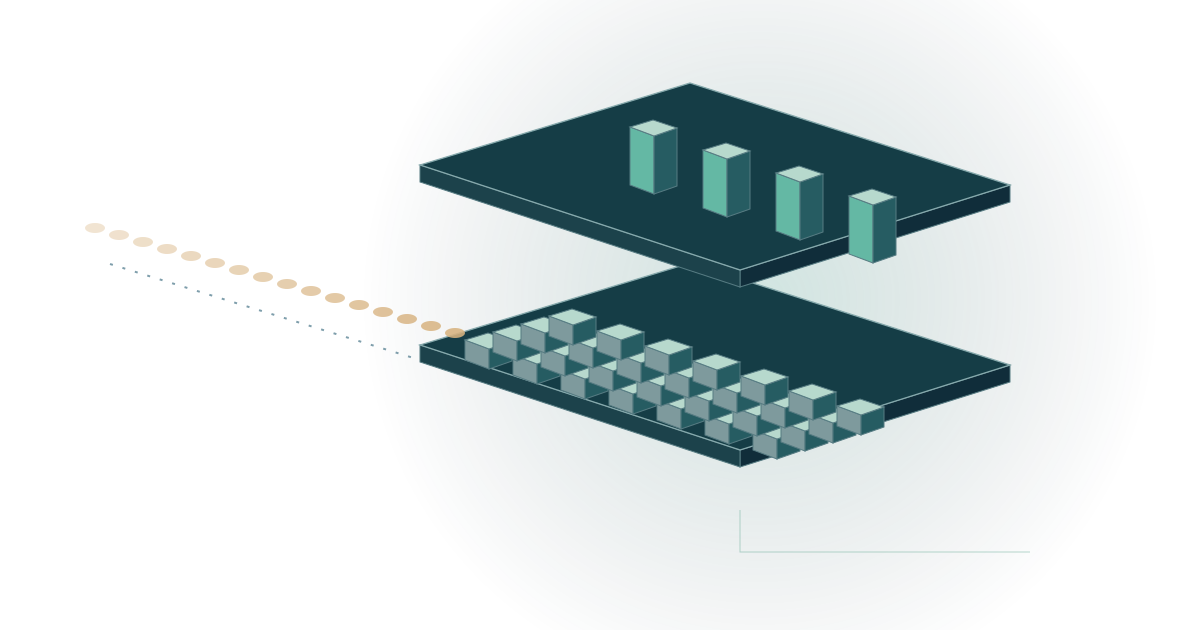
Eintritt — Billig annehmen, ablehnen oder aufschieben; Bewahren Sie die Operationsidentität. · Wartearbeit — Gebundene Lagerung und Nutzungsdauer; Trennen Sie die Live-Anfrage von der Wiedergabe. · Aktive Ausführung — Beschränken Sie die tatsächliche Abhängigkeitsarbeit während des Fluges und nicht nur auf wartende Anrufer. · Abhängigkeit — Respektieren Sie seine Kapazität; Geben Sie die Wiederherstellungsarbeit in einem kontrollierten Tempo frei.
Die isometrische Ansicht trennt vier Belange, die häufig in einer Servicebox zusammengefasst werden: Zulassung, Warten, aktive Ausführung und die Downstream-Abhängigkeit. Jede Schicht verfügt über eine andere knappe Ressource. Der Zulassungsweg muss eine schnelle Entscheidung treffen. Der Puffer verfügt über einen endlichen Speicher und eine Altersverteilung. Worker verbrauchen Speicher, Verbindungsslots und Ausführungszeit. Die Abhängigkeit verfügt über eine eigene Kapazitäts- und Berechtigungsgrenze. Die Sichtbarkeit dieser Ebenen hilft zu erklären, warum eine Erhöhung der Arbeitszahl nicht gleichbedeutend mit einer Erhöhung der Kapazität des gesamten Dienstes ist. Ein Limit auf einer Ebene kann umgangen werden, wenn die nächste Ebene Anleihen aus einem unbegrenzten gemeinsamen Pool bezieht.
Nehmen wir einen Worker, der sich auf eine bescheidene Anzahl aktiver Jobs beschränkt, aber jedem Job erlaubt, viele gleichzeitige Downstream-Aufrufe zu öffnen. Das Limit auf der obersten Ebene scheint verantwortlich zu sein, doch die Ressource, auf die es ankommt, wird darunter vervielfacht. Das gleiche Problem tritt auf, wenn eine Zeitüberschreitung eine Genehmigung auf Anwendungsebene freigibt, bevor der zugrunde liegende Vorgang tatsächlich aufgehört hat, die Abhängigkeit zu nutzen. Der Begrenzer zählt eine Sache, während die Ressource für eine andere bezahlt. Der Entwurf sollte den Zeitpunkt angeben, an dem eine Genehmigung erworben wird, die Arbeiten, die sie umfasst, und die Beobachtung, die ihre Erteilung rechtfertigt.
Die Isolierung ist nützlich, da nicht verwandte Arbeiten nicht ihre gesamte Kapazität an die langsamste Abhängigkeit verlieren sollten. Separate Pools oder Parallelitätszulagen können verhindern, dass eine fehlerhafte Integration die Ressourcen belegt, die eine gesunde Integration benötigt. Das ist nicht kostenlos. Partitionen können die Kapazität ungenutzt lassen, während eine andere Partition ausgelastet ist, und zu viele Partitionen können die Optimierung des Systems erschweren. Der Wert ist eine vorhersehbarere Fehlergrenze. Die Auswahl sollte im Hinblick darauf erklärt werden, welche Arbeitslasten sich gegenseitig beeinflussen können, anstatt Bulkheads als universelle Anweisung darzustellen, um für jede Funktion eine separate Warteschlange und einen Thread-Pool zu erstellen.
Ein Leistungsschalter trifft eine andere Entscheidung als eine Wiederholungsrichtlinie. Es kann Versuche, eine Ressource mit hinreichender Wahrscheinlichkeit zum Scheitern zu bringen, vorübergehend stoppen und ermöglicht es kontrollierten Tests, die Wiederherstellung zu bewerten. Das Muster von Microsoft beschreibt diese Trennung. Für den hypothetischen Dienst ist die interessante Frage, was rund um den Breaker passiert: ob blockierte Versuche ein Wiederholungsbudget verbrauchen, ob Fallback-Arbeiten dieselbe fehlgeschlagene Abhängigkeit verwenden und ob die Probe-Population über alle Instanzen hinweg begrenzt bleibt. Ein in einem Architekturdiagramm gezeichneter Leistungsschalter legt allein nicht das umgebende Verhalten fest. [4]
Ein Rückfall kann die Situation unbeabsichtigt verschlimmern. Wenn bei einem Cache-Miss jede Anfrage an die ursprüngliche Abhängigkeit gesendet wird, kann ein scheinbar stabiler Cache-Pfad die Last während eines Zeitraums mit schlechter Trefferquote konzentrieren. Wenn ein alternativer Anbieter über ein geringeres Kontingent verfügt, kann der Vorfall durch einen Wechsel aller Anrufer auf einmal übertragen werden. Wenn die Berechnung einer verschlechterten Antwort teuer ist, bleibt möglicherweise nicht genügend Kapazität erhalten, um nützlich zu sein. Ein Fallback sollte als eine weitere Arbeitslast mit eigenen Abhängigkeiten und Korrektheitsbedingungen bewertet werden. Sein Name ist kein Beweis dafür, dass es billiger, sicherer oder in der Größenordnung des ausgefallenen Primärpfads verfügbar ist.
Es gibt auch Aufgaben, für die veraltete Informationen nicht akzeptabel sind. Die Rückgabe eines älteren Informationsergebnisses mit einem sichtbaren Zeitstempel kann für einige Leser eine erhebliche Beeinträchtigung darstellen. Ein anderes Risiko besteht darin, eine alte Genehmigungsentscheidung zu verwenden oder einen veralteten Geschäftsstatus als aktuell darzustellen. Die Anwendung muss entscheiden, welche Teile des Ergebnisses sich verschlechtern können, wie diese Bedingung kommuniziert wird und welche Vorgänge abgelehnt werden müssen. Die Wahrung der Verfügbarkeit durch das Verbergen von Unsicherheiten kann dem Unternehmen schaden, auch wenn dadurch das Fehlerraten-Dashboard besser aussieht. Die Fehlerantwort sollte eine wahrheitsgetreue Darstellung dessen liefern, was der Dienst weiß.
Bei der Behandlung von Überlastung durch Google geht es um eingeschränkte Antworten und die Notwendigkeit, Arbeit abzulehnen, wenn selbst eine reduzierte Antwort nicht bedient werden kann. Das liefert einen nützlichen Kontext für eine Designentscheidung, die ansonsten defätistisch klingen könnte: Das Ablehnen einiger Anfragen kann die Fähigkeit schützen, andere zu erfüllen. Die Geschäftsprioritäten für den hypothetischen Dienst werden nicht ausgewählt. Diese Prioritäten erfordern einen expliziten Vertrag darüber, welche Aufgaben warten dürfen, welche sich verschlechtern können und welche schnell ausfallen sollten. Der technische Mechanismus muss dann diesen Vertrag durchsetzen und ihn nicht nur in einem Dokument festhalten. [5]
5. Backoff ändert den Zeitpunkt; Jitter verändert das Unternehmen
Bei zwei Kunden kann es zu individuell spürbaren Verzögerungen kommen und sie trotzdem gemeinsam ankommen. Wenn eine große Population im selben Moment ausfällt und jedes Mitglied im gleichen Zeitraum wartet, kann die nächste Welle synchronisiert bleiben. Eine zunehmende Verzögerung verändert den Abstand zwischen den Wellen, ohne notwendigerweise die Mitglieder jeder Welle zu zerstreuen. Jitter führt zu Variationen in ihrem Timing. Der wichtige Gedanke ist nicht der Zufall als dekorative Ergänzung einer Formel. Es geht darum, eine Erholungspopulation zu vermeiden, die sich immer wieder als ein koordinierter Ausbruch darstellt. Die erforderliche Verteilung und Grenzen sollten zum Protokoll, den Fristen und der beobachteten Arbeitsbelastung passen.
Die AWS-Diskussion über exponentielles Backoff und Jitter veranschaulicht, warum ein deterministisches Wiederholungstiming zu Arbeitsclustern führen kann. Dies unterstützt den Timing-Mechanismus und keine universelle Parameterauswahl für einen anderen Dienst. In der hypothetischen Anwendung könnte eine längere zufällige Verzögerung die Versuche verteilen, einige aber auch über die nützliche Frist des Anrufers hinausschieben. Eine kürzere Reichweite passt möglicherweise zur Deadline, trägt aber zu wenig zur Verringerung der Synchronisierung bei. Das Design benötigt beide Einschränkungen. Ein gewählter Algorithmusname sollte nicht als Beweis dafür betrachtet werden, dass jede generierte Verzögerung für die Aufgabe geeignet ist. [6]
Eine Wiederholungsschleife erfordert auch eine Interpretation der Antwort. Ein Authentifizierungsfehler, eine abgelehnte Geschäftsregel und eine vorübergehende Kapazitätsbeschränkung erfordern nicht dasselbe Verhalten. Das Wiederholen einer unveränderten ungültigen Anfrage kann normalerweise nicht die Informationen reparieren, die sie ungültig gemacht haben. Eine Drosselungsreaktion kann eine zeitliche Orientierung bieten, der Anrufer muss jedoch dennoch seine eigene Frist und Gesamtvorgabe einhalten. Ein Verbindungsfehler kann die Ausführung unsicher machen. Die Klassifizierung sollte zu einer Entscheidung über den Vorgang führen und nicht nur zu einer Suche, die jeder Ausnahme eine andere Anzahl von Versuchen zuweist.
Der Versuchsplan sollte die Zeit umfassen, die für die Durchführung nützlicher Arbeiten, das Warten auf eine Antwort und das Warten vor einem weiteren Versuch aufgewendet wird. Eine Richtlinie kann kurz erscheinen, wenn ihre Verzögerungen separat aufgeführt werden, aber nach Einbeziehung der Ausführung die gesamte Zeitvorgabe der Aufgabe überschreiten. Es sollten auch sich überschneidende Versuche berücksichtigt werden, wenn der Antrag dies zulässt. Parallele Spekulation kann manchmal die Latenz reduzieren, erfordert dafür aber zusätzliche Kapazität. Bei Überlastung kann dieser Kompromiss besonders teuer sein. Eine Organisation sollte wissen, wann der Dienst diese Entscheidung trifft, welche Vorgänge qualifiziert sind und was die zusätzliche Arbeit verhindert.
Der Zeitplan ist nicht die einzige Quelle der Synchronisierung. Regelmäßige Abfragen, Token-Aktualisierungen, geplante Batch-Starts und eine Reihe von Prozessen, die nach einem gemeinsamen Ereignis neu gestartet werden, können alle die Aktivität konzentrieren. Der hypothetische Ausfall könnte daher auch nach einer Verbesserung der expliziten Wiederholungsschleife erneut auftreten. Die nützliche Untersuchung fragt, welche Uhren in der gesamten Arbeitslast gemeinsam genutzt werden und welche teuren Aktionen sie auslösen. Die Verteilung der Hintergrundarbeit kann hilfreich sein, aber Fristen, Geschäftszeiten und externe Servicefenster können diese Freiheit einschränken. Eine korrekte Lösung ändert das relevante Ankunftsmuster und behält gleichzeitig den Zweck der geplanten Aufgabe bei.
Der Anrufer, der die Taste erneut drückt
Personen können eine weitere Wiederholungsebene sein. Ein Bildschirm, der sich dreht, ohne zu erklären, ob eine Anfrage angenommen wurde, lädt zur erneuten Einreichung ein. Eine deaktivierte Schaltfläche kann versehentliche Duplikate reduzieren, kann jedoch den Status des Servers nach einer verlorenen Antwort nicht ermitteln. Eine dauerhafte Betriebsreferenz und eine klare Statusansicht können dem Leser die Möglichkeit geben, die erste Anfrage zu prüfen, anstatt eine weitere zu erstellen. Die Schnittstelle sollte das Warten auf eine akzeptierte Operation von der Aufforderung an den Server unterscheiden, eine neue Operation zu starten. Diese Unterscheidung wird besonders wertvoll, wenn eine kurze interaktive Frist einem längeren asynchronen Prozess vorausgeht.
Der Wortlaut ist wichtig, weil die Software ein Versprechen gibt. Zu sagen, dass eine Anfrage fehlgeschlagen ist, obwohl ihr Ergebnis unbekannt ist, ist eine andere Handlung als die Aussage, dass die Verarbeitung akzeptiert wurde und ihr Status überprüft wird. Keine der beiden Nachrichten sollte Gewissheit beanspruchen, über die das System nicht verfügt. Die Statusansicht muss außerdem verhindern, dass sie während des Vorfalls zu einer unkontrollierten Abfragequelle wird. Die Wahl des Intervalls, gegebenenfalls das Zwischenspeichern des Status und die Begrenzung wiederholter Aktualisierungen sind Teil desselben Kapazitätsdesigns. Eine nützliche Benutzererfahrung hilft den Menschen, ihre Absicht wiederzuerlangen, ohne ihre Unsicherheit in eine weitere Welle von Arbeit zu verwandeln.
6. Der Erholungsverkehr braucht eine Route nach Hause
Ein warteschlangengesteuerter Dienst führt eine weitere Unterscheidung ein: erfolgreiche Verarbeitung und erfolgreiche Bestätigung sind separate Ereignisse. Der geschäftliche Effekt kann abgeschlossen sein, bevor der Broker erfährt, dass die Nachricht entfernt werden kann. Wenn die Bestätigung verloren geht, kann das System die Nachricht erneut sehen. Azure Service Bus dokumentiert Übertragungen, Sperren und Abrechnung als separate Teile der Lieferung. Die architektonische Konsequenz besteht darin, die Verarbeitungsidentität der Nachricht mit dem Geschäftsbetrieb zu verbinden und die wiederholte Zustellung bewusst zu handhaben. Eine Erhöhung des Schwellenwerts für die Zustellungsanzahl stellt nicht sicher, dass eine wiederholte Ausführung sicher ist. [7]
Der Arbeitnehmer muss auch Arbeiten anerkennen, die durch Wiederholung keine Gültigkeit erlangen. Eine fehlerhafte Nutzlast, eine nicht unterstützte Betriebsversion oder eine dauerhaft fehlende Voraussetzung erfordern möglicherweise eine Korrektur oder Untersuchung. Wenn Sie es auf unbestimmte Zeit in die aktive Warteschlange zurückführen, wird möglicherweise Kapazität verbraucht, ohne dass sich die Erfolgsaussichten verbessern. Ein separater Fehlerpfad kann die normale Arbeitslast am Laufen halten, aber dieser Pfad benötigt einen Besitzer und eine sichtbare Konsequenz. Eine Warteschlange für unzustellbare Nachrichten, deren Inhalt nie untersucht wird, ist keine Wiederherstellungsstrategie; Es handelt sich um eine Ansammlung ungelöster Versprechen, die zufällig außerhalb des Hauptdurchsatzdiagramms liegt.
In der Service Bus-Dokumentation zu unzustellbaren Nachrichten von Microsoft wird die Rolle der sekundären Unterwarteschlange und die Notwendigkeit erläutert, dass Anwendungen ihre Nachrichten verarbeiten müssen. Die wichtige Entscheidung für den hypothetischen Dienst ist, was vor einer erneuten Übermittlung geschieht. Das Team muss feststellen, ob der zugrunde liegende Fehler behoben wurde, ob die ursprüngliche Geschäftsabsicht noch aktuell ist und ob ein früherer Versuch bereits Wirkung gezeigt hat. Eine Massenwiederholung, bei der diese Fragen übersprungen werden, kann alte Unsicherheit in neue Belastung umwandeln. Das Wiederherstellungsverfahren sollte in der Lage sein, Arbeit auszuwählen, anstatt jede gespeicherte Nachricht als gleichermaßen sicher für die erneute Ausführung zu behandeln. [8]
Wenn die Kapazität zurückkehrt, konkurrieren Live-Nachfrage und historische Wiederherstellungsarbeiten. Ein Dienst, der alle alten Aufgaben mit der maximal verfügbaren Rate entleert, kann aktuellen Benutzern einen zweiten Ausfall bescheren. Ein Dienst, der alles für neue Arbeiten reserviert, wird den Rückstand möglicherweise nie abbauen. Die Freigaberate für Wiederherstellungsarbeiten erfordert daher eine Richtlinie, die an die tatsächliche freie Kapazität und die Geschäftspriorität gekoppelt ist. Es kann angepasst werden, wenn sich das Verhalten der Abhängigkeit ändert. Der wesentliche Punkt ist, dass die Wiederherstellung eine eigenständige Arbeitsbelastung ist und keine spezielle Kategorie, die von den für den normalen Verkehr geltenden Beschränkungen ausgenommen ist.
Die Wiederherstellungsentscheidung unterliegt auch einer Stoppbedingung. Eine Wiedergabe muss möglicherweise angehalten werden, wenn die Latenz zunimmt, wenn die älteste Live-Anfrage ihr Nutzungsalter überschreitet, wenn die Duplikaterkennung ein unerwartetes Muster findet oder wenn eine Abhängigkeit erneut mit der Drosselung beginnt. Die entsprechenden Signale hängen vom Dienst ab. Wichtig ist, dass die Person oder der Mechanismus, der alte Arbeiten freigibt, diese beobachten und handeln kann, bevor der Puffer zur Quelle eines weiteren Anstiegs wird. Ein Wiederholungsbefehl ohne Feedback-Pfad bietet Beständigkeit, aber wenig Kontrolle über seine Folgen.
Durch die Wahrung der Herkunft wird dieses Feedback nützlicher. Ein Vorgang sollte über seine erste Übermittlung, spätere Versuche, Warteschlangenlieferungen und alle manuellen Korrekturen nachvollziehbar sein. Um dies zu erreichen, müssen die Identifikatoren keine sensiblen Inhalte offenlegen. Sie benötigen eine stabile Beziehung zur Geschäftsabsicht und ausreichend Konfigurationskontext, um die Richtlinie zu erklären, nach der jeder Versuch ausgeführt wurde. Ohne diese Kontinuität kann ein Team seine Reaktion auf Vorfälle damit verbringen, zu entscheiden, ob es sich um einen hartnäckigen Vorgang, viele neue Anfragen oder eine Mischung aus beidem handelt. Das zusätzliche Protokollierungsvolumen stellt dann einen weiteren Ressourcendruck dar, ohne dass das erforderliche Verständnis vermittelt wird.
7. Suchen Sie nach der Arbeit, die erledigt wird
Ein Dienst kann gleichzeitig ausgelastet, verfügbar und nicht hilfreich sein. CPU, Verbindungsauslastung und Anforderungsrate beschreiben die Aktivität, während nützliche Abschlüsse den Fortschritt beschreiben. Keine Kategorie ersetzt die andere. Die interessante Beobachtung ist, wie sie voneinander abweichen. Wenn die Zahl der Versuche zunimmt, während die einzelnen abgeschlossenen Vorgänge zurückgehen, gibt der Dienst möglicherweise mehr aus, um weniger zu erreichen. Wenn sich die Latenz nur verbessert, weil ein größerer Teil der Arbeit abgelehnt wird, hat die Anwendung möglicherweise ihre Ressourcen geschont, während viele Leser dennoch scheitern. Die Betriebsansicht sollte beide Fakten sichtbar machen, anstatt sich für die Metrik zu entscheiden, die die beruhigendere Aussage liefert.
Der Nenner ist besonders wichtig für eine Anwendung, die einen Wiederholungsversuch durchführt. Eine Erfolgsquote auf Versuchsebene kann durch die Anzahl der Versuche pro Vorgang verzerrt sein. Eine Abschlussrate auf Benutzerebene kann den Umfang des Ressourcenverbrauchs verbergen, der für den jeweiligen Erfolg erforderlich ist. Ein nützliches Dashboard trennt den ursprünglichen Bedarf, die Gesamtzahl der Versuche, die zugelassene Arbeit, einzelne abgeschlossene Vorgänge, die Zeit bis zum sinnvollen Abschluss und die Ergebnisse, die noch ungewiss sind. Es zeigt auch Alter und Arbeitsbelastungsklasse, bei denen diese Unterschiede die Entscheidung beeinflussen. Diese Maßnahmen beschreiben unterschiedliche Fragestellungen; Sie zu sammeln ist nur dann sinnvoll, wenn das Team eine Änderung mit einer Aktion in Verbindung bringen kann.
Ein Diagnoseverhältnis besteht aus versuchten Abhängigkeitsaufrufen pro ursprünglichem Vorgang. Ein weiterer Grund ist der Anteil der knappen Ausführungszeit, der für Vorgänge aufgewendet wird, deren Einleitungsfrist bereits abgelaufen ist. Beides sollte nicht als Universaldienstziel betrachtet werden. Sie sind Möglichkeiten, einen vermuteten Mechanismus sichtbar zu machen. Die Definition muss präzise genug sein, um zu vermeiden, dass eine harmlose Verbindungswiederherstellung als zusätzliche Geschäftsausführung gezählt oder eine absichtlich asynchrone Aufgabe als aufgegebene Arbeit behandelt wird. Die Maßnahme ist dann wertvoll, wenn sie zwischen Erklärungen unterscheidet, und nicht, wenn sie eine weitere attraktive Zeile auf dem Vorfall-Dashboard liefert.
Die Kosten sind Teil dieser Beobachtung. Durch die zusätzlichen Versuche können sich die Anfragegebühren, das Protokollierungsvolumen, die Verbindungsabwanderung oder der Rechenverbrauch erhöhen, selbst wenn dadurch keine weitere Geschäftsarbeit erledigt wird. Die Kosten pro Anfrage können sich scheinbar verbessern, wenn der Nenner mit den Wiederholungsversuchen wächst, während die Kosten pro nützlichem Ergebnis sinken. Die Organisation benötigt eine Kostenansicht, die die Aufgabe weit genug verfolgt, um fehlgeschlagene und wiederholte Anstrengungen einzubeziehen. Hier werden keine Ersparnisse geltend gemacht. Es geht darum, eine Buchhaltungsgrenze zu wählen, die zeigt, ob eine vorgeschlagene Resilienzänderung die Verschwendung reduziert, anstatt sie einfach auf einen anderen Service oder eine andere Rechnung zu verschieben.
Testen Sie die Kette, nicht nur die Schleife
Ein erfolgreicher Wiederholungsversuch in einem Komponententest sagt nur sehr wenig über eine Flotte aus, bei der ein entsprechender Fehler auftritt. Ein aufschlussreicherer kontrollierter Test ändert die Latenz oder Abschlusskapazität einer Abhängigkeit, während der ursprüngliche Bedarf identifizierbar bleibt. Dabei wird beobachtet, ob die Versuchsverstärkung begrenzt bleibt, ob Fristen wie vorgesehen enden und ob sich der Nutzdurchsatz nach der Störung erholt. Die Umgebung und die Grenzwerte sollten diesen Test sicher machen. Das Ziel besteht nicht darin, einen unkontrollierten Produktionsvorfall herbeizuführen, um Härte zu demonstrieren. Damit soll die spezifische Annahme in Frage gestellt werden, dass zusätzliche Versuche weiterhin hilfreich sind, wenn viele Anrufer gemeinsam scheitern.
Die Szenarien sollten zwischen langsamen Reaktionen, eindeutigen Ablehnungen und unbekannten Ergebnissen unterscheiden. Sie sollten eine Abhängigkeit enthalten, die vor Ablauf der Frist des Anrufers wiederhergestellt wird, und eine, die dies nicht tut. Ein warteschlangenbasierter Dienst sollte auch Bestätigungsunsicherheit, abgelaufene Arbeit und eine absichtlich eingeschränkte Wiedergabe ermöglichen. Das erwartete Ergebnis besteht nicht einfach darin, dass jede übermittelte Aufgabe irgendwann erfolgreich ist. Einige Aufgaben sollten abgelehnt oder aufgegeben werden. Die sinnvolle Frage ist, ob das beobachtete Ergebnis mit dem Vertrag übereinstimmt, während die eingeschränkte Ressource geschützt bleibt und die Organisation erklären kann, was mit jeder Arbeitsklasse passiert ist.
Ein Vergleich erfordert die gleiche ursprüngliche Forderung. Andernfalls könnte eine Konfiguration, die scheinbar schneller wiederhergestellt wird, lediglich eine geringere Arbeitslast erhalten haben. Das Konto sollte das für das Ergebnis relevante Ankunftsmuster, den Aufgabenmix, die Abhängigkeitsbedingung und die Konfigurationsversionen beibehalten. Es sollte berechnete Beispiele wie das Diagramm in diesem Artikel von Messungen unterscheiden, die in einem laufenden Test erhalten wurden. Die Wiederholung einer plausiblen numerischen Geschichte, als wäre sie ein Maßstab, würde die Beweise schwächen. Ein transparentes kleines Modell ist nützlich, weil seine Annahmen in Frage gestellt werden können, und nicht, weil seine glatten Linien einer Produktionsspur ähneln.
8. Das System, das es nicht mehr versuchen darf
Kehren Sie zur ersten verzögerten Anfrage zurück. Es musste nicht zu einem Ausfall kommen. Die Fehlerkette erlangte ihre Kraft durch mehrere Übergänge: Eine Auszeit wurde als Erlaubnis interpretiert, mit der weiteren Arbeit zu beginnen; Schichten vervielfachten Versuche ohne ein gemeinsames Budget; Die Wartearbeit verbarg eine wachsende Kapazitätslücke. und der Wiederherstellungsverkehr wurde so behandelt, als würde seine Dringlichkeit zusätzlichen Durchsatz erzeugen. Jeder Übergang bietet eine Möglichkeit, die Kette zu unterbrechen. Das Design benötigt nicht jedes mögliche Elastizitätsmuster. Es braucht Kontrollen an den Punkten, an denen dieser Dienst Unsicherheit in zusätzliche Belastung oder einen wiederholten Geschäftseffekt verwandeln kann.
Es gibt Umstände, in denen ein weiterer Versuch genau die richtige Reaktion ist. Ein kurzer unabhängiger Fehler kann verschwinden, ein sicherer Lesevorgang kann auf einer anderen Route schnell abgeschlossen werden oder eine begrenzte erneute Übermittlung kann eine wertvolle Aufgabe wiederherstellen. Das Argument richtet sich nicht gegen die Beharrlichkeit. Es ist die Beharrlichkeit, die der Zeit, der Kapazität und der Bedeutung der Operation Rechnung trägt. Ein Dienst sollte erklären können, warum ein Versuch unternommen wurde, welche Entschädigung dafür gezahlt wurde und welche Beobachtung den nächsten Versuch verhindern würde. Diese Erklärung ist nützlicher als eine allgemeine Aussage, dass Wiederholungsversuche aus Gründen der Zuverlässigkeit aktiviert wurden.
Die wichtigste Wiederherstellungsfähigkeit dürfte daher die Fähigkeit zum Anhalten sein. Hören Sie auf, Versuche zu unternehmen, wenn deren Ergebnis nach Ablauf der Frist unbrauchbar geworden ist. Hören Sie auf, Kapazitäten von unabhängiger Arbeit zu leihen. Hören Sie auf, einen Rückstand erneut abzuspielen, wenn der Live-Dienst zu leiden beginnt. Hören Sie auf, einen definitiven Misserfolg zu behaupten, wenn das Ergebnis der Ausführung noch unbekannt ist. Dies sind unterschiedliche Entscheidungen, und jede erfordert einen geeigneten Eigentümer oder Mechanismus. Zusammen schaffen sie Raum für die Wiederherstellung der zugrunde liegenden Abhängigkeit und für die Organisation, die verbleibende Arbeit zu korrigieren, anstatt jede ungelöste Absicht auf denselben überlasteten Weg zurückzudrängen.
Ein zuverlässiger Service verspricht nicht, dass man es ewig versuchen muss. Es gibt ein praktischeres Versprechen: Angenommene Arbeit hat eine definierte Bedeutung, zusätzlicher Aufwand hat eine Grenze und ein Misserfolg führt zu einem Ergebnis, das die Menschen verstehen und entsprechend handeln können. Wenn diese Bedingungen erfüllt sind, können Wiederholungsversuche ein nützliches Werkzeug bleiben und werden nicht zu einer unsichtbaren Arbeitslast ohne rechenschaftspflichtigen Kunden. Der Unterschied zeigt sich am deutlichsten während der Erholung. Wenn der ursprüngliche Fehler verschwindet, hat das System genügend Kontrolle über sein eigenes Verhalten, um die nützliche Arbeit wieder aufnehmen zu können.